geometrics — Explorar app
Mapee y describa regiones: coropletas, pesos espaciales, diagramas de Moran, mapas de clústeres LISA y vistas espacio-temporales.
Aplicaciones interactivas para explorar datos y aprender métodos en el navegador: paneles de Google Earth Engine, aplicaciones de Streamlit y las aplicaciones complementarias de los tutoriales.
Mapee y describa regiones: coropletas, pesos espaciales, diagramas de Moran, mapas de clústeres LISA y vistas espacio-temporales.
Entornos de prueba ejecutables y explicaciones sencillas de los métodos de convergencia y desigualdad espacial.
Estime convergencia beta, sigma y por clubes, modelos econométricos espaciales, dinámica de Markov, desigualdad Gini/Theil y (M)GWR.
Describa y visualice un panel: distribuciones, valores faltantes, tendencias, variación within/between y dinámica del panel.
Entornos de prueba ejecutables y explicaciones sencillas de los métodos de datos de panel.
Estime efectos fijos, aleatorios y aleatorios correlacionados, FWL, pruebas de Hausman, estudios de eventos, convergencia y ondas de Kuznets.
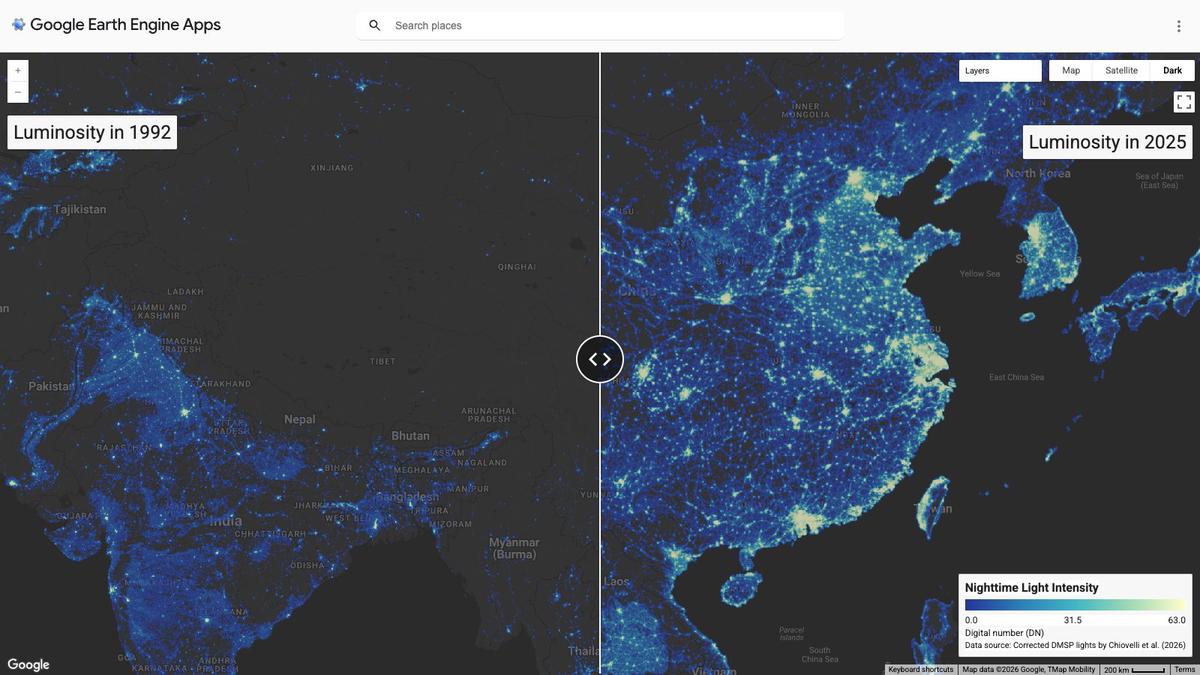
Aplicación interactiva de Google Earth Engine.
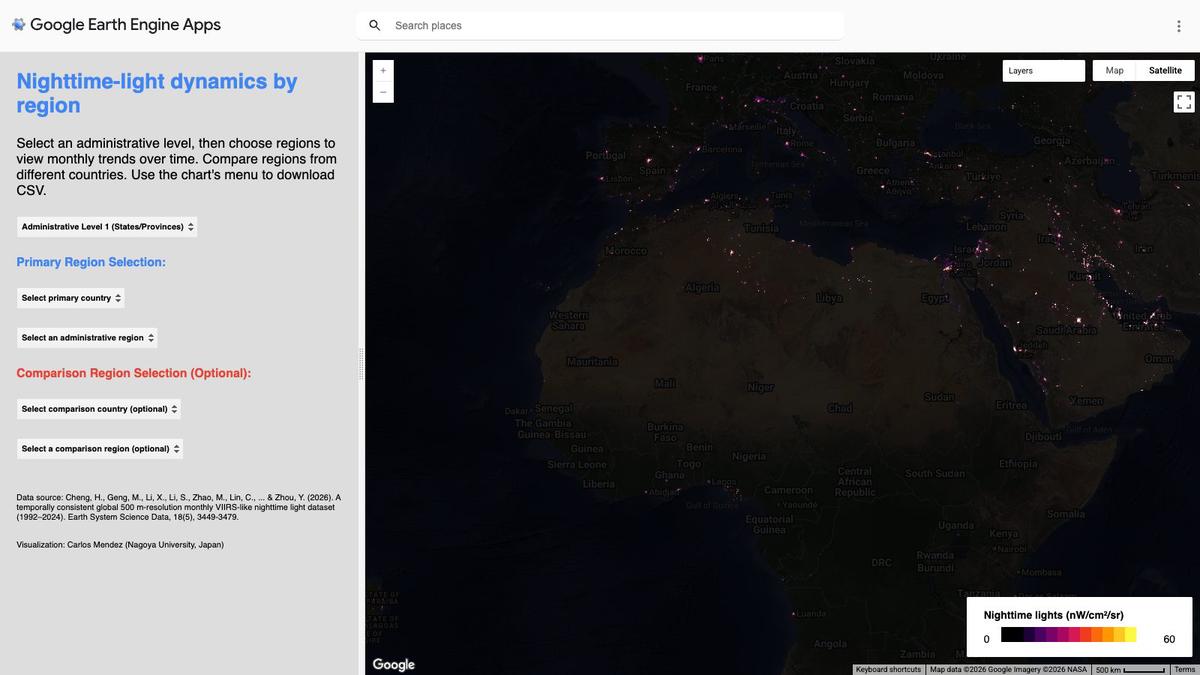
Aplicación interactiva de Google Earth Engine.
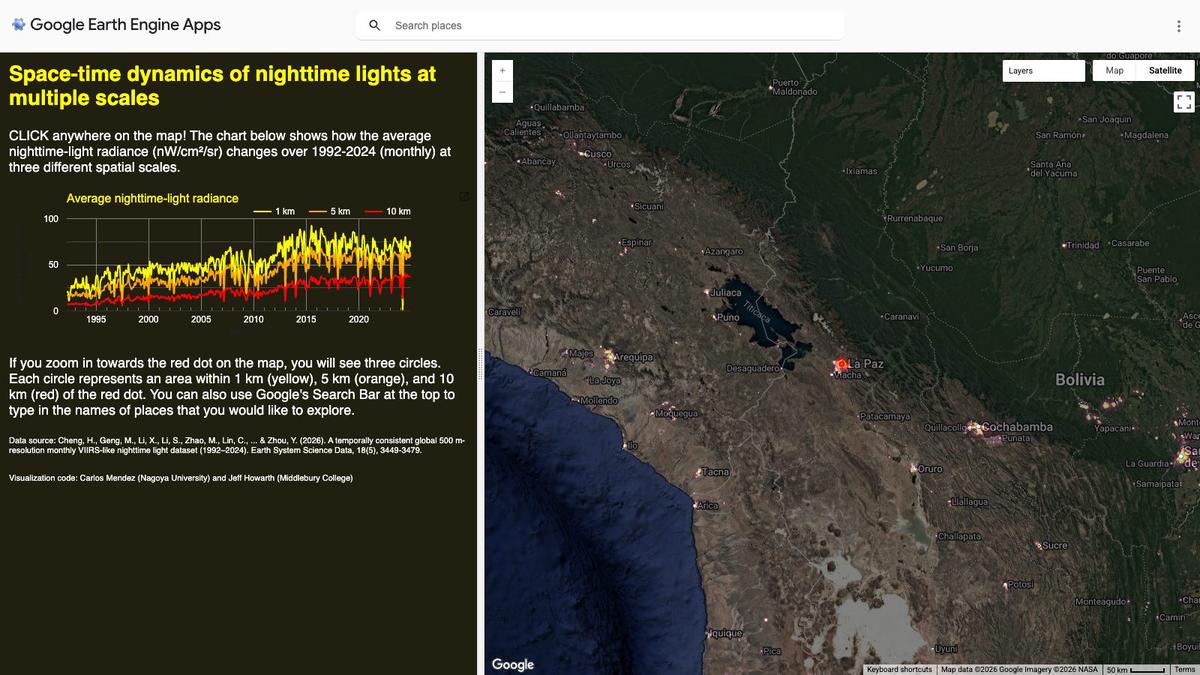
Aplicación interactiva de Google Earth Engine.
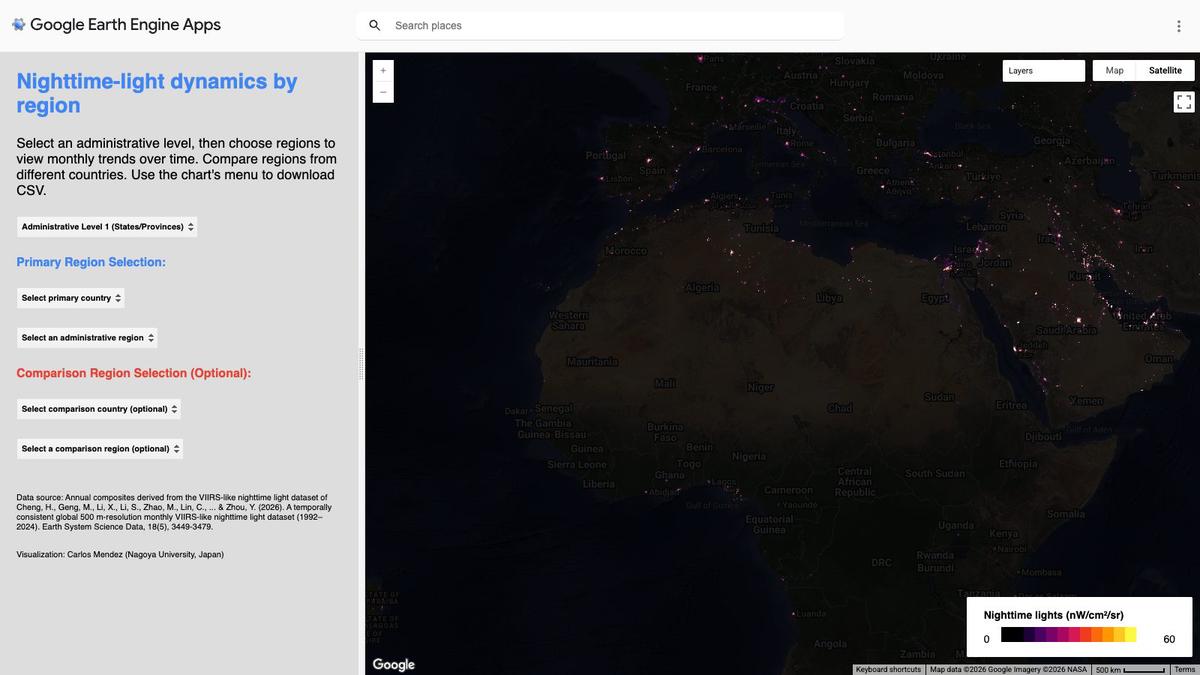
Aplicación interactiva de Google Earth Engine.
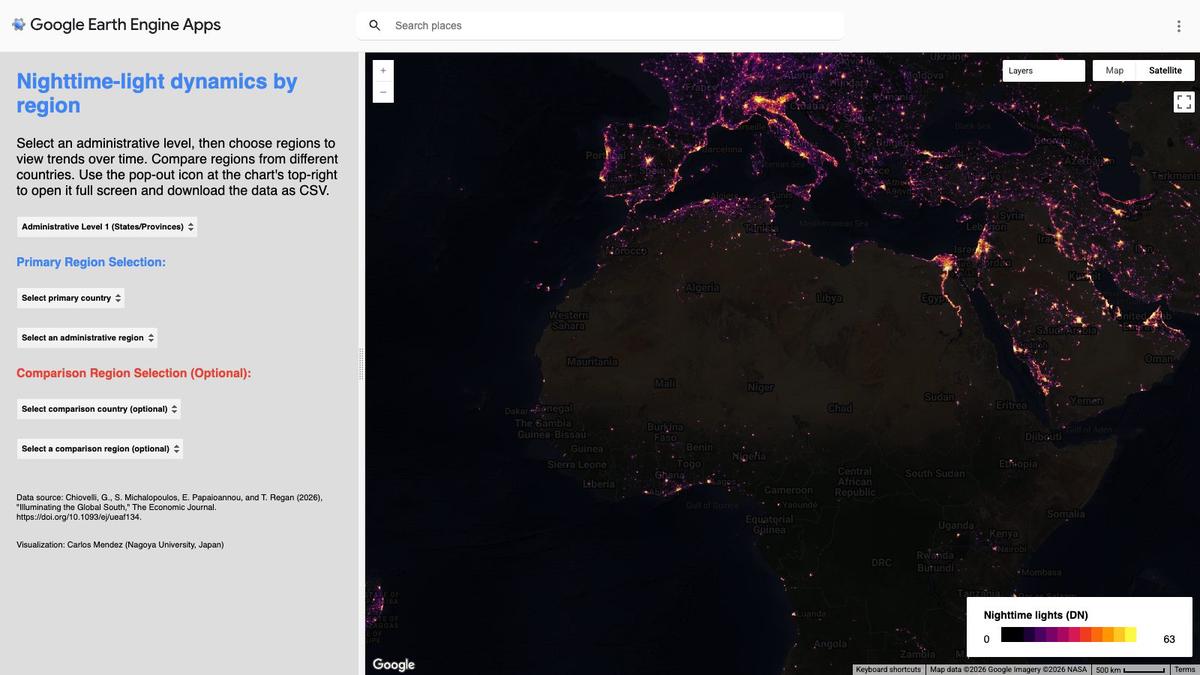
Aplicación interactiva de Google Earth Engine.
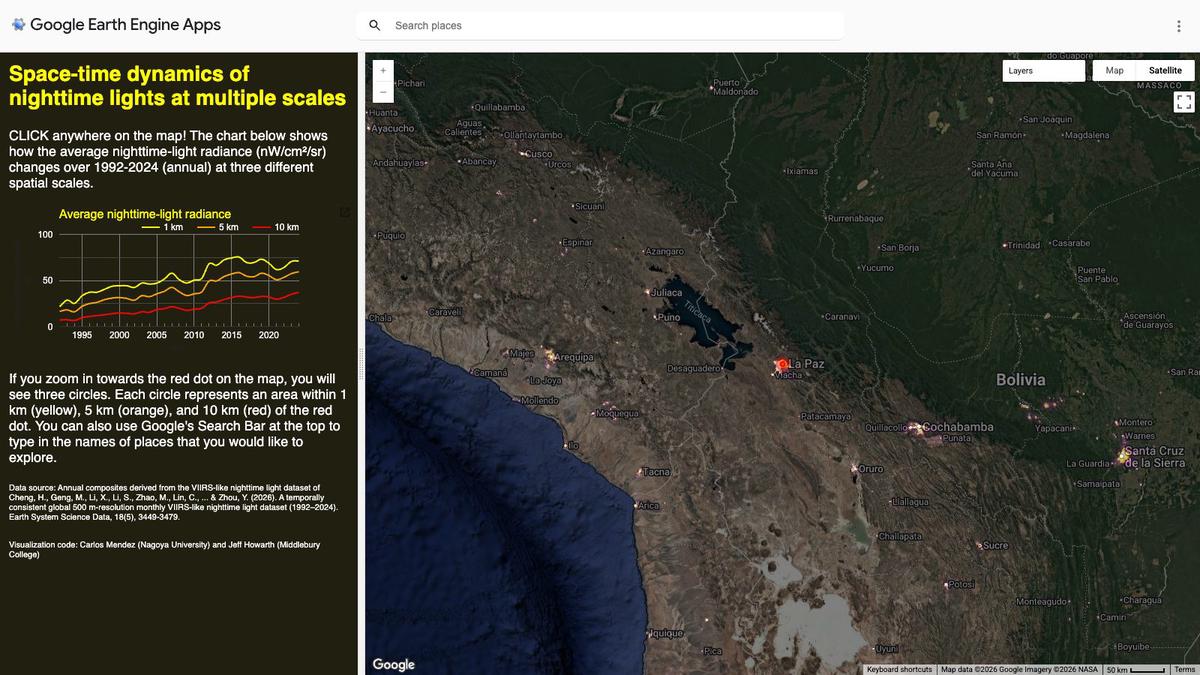
Aplicación interactiva de Google Earth Engine.
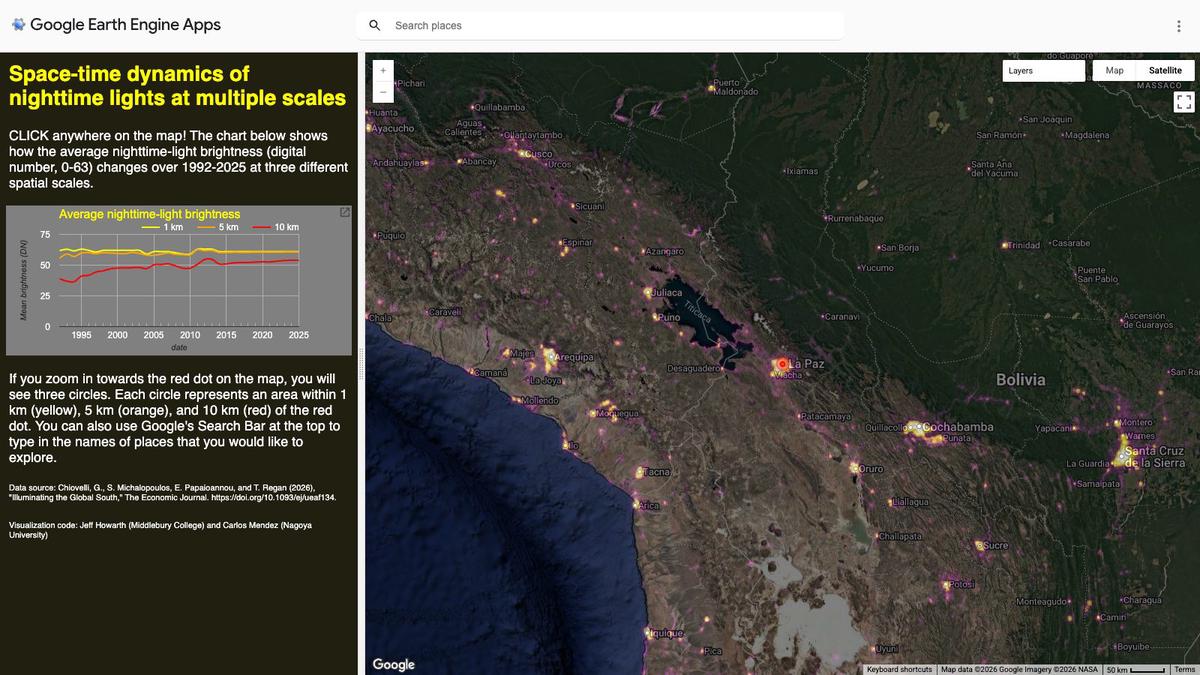
Aplicación interactiva de Google Earth Engine.
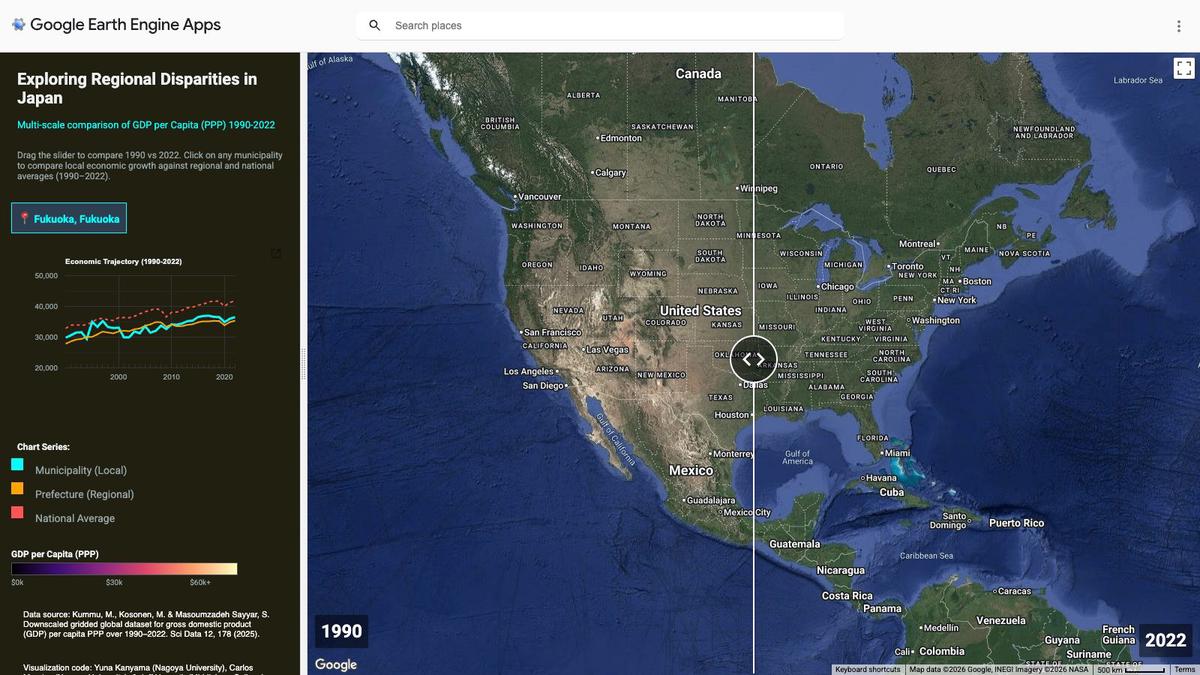
Aplicación interactiva de Google Earth Engine.
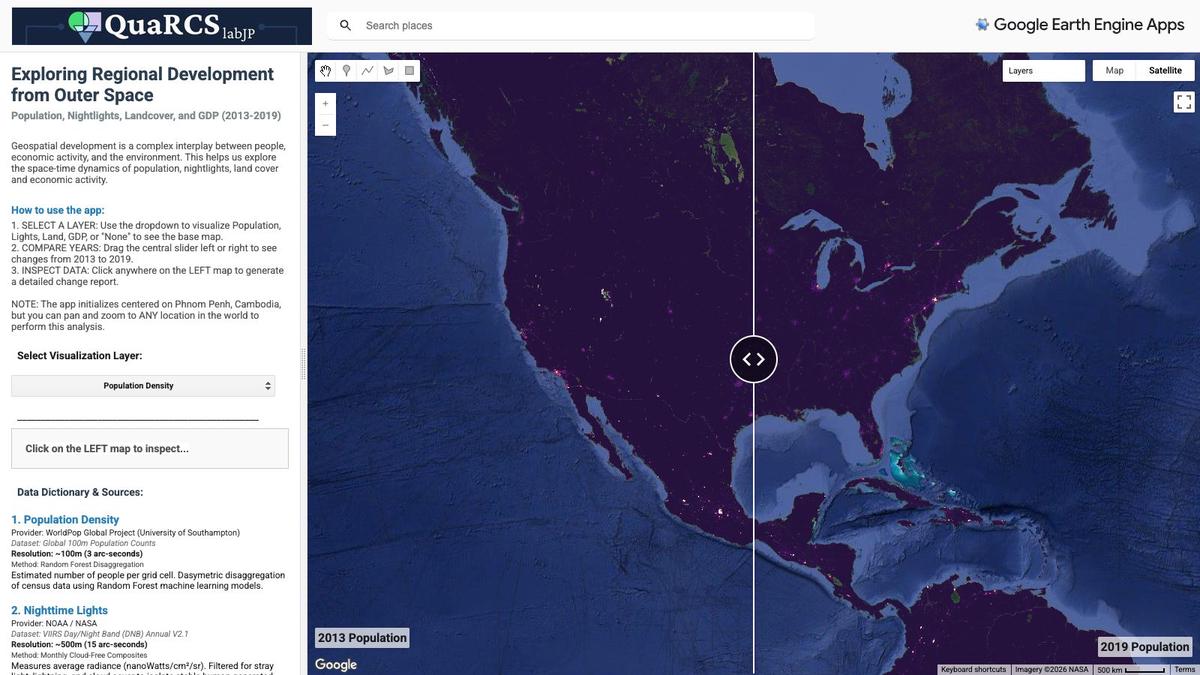
Aplicación interactiva de Google Earth Engine.
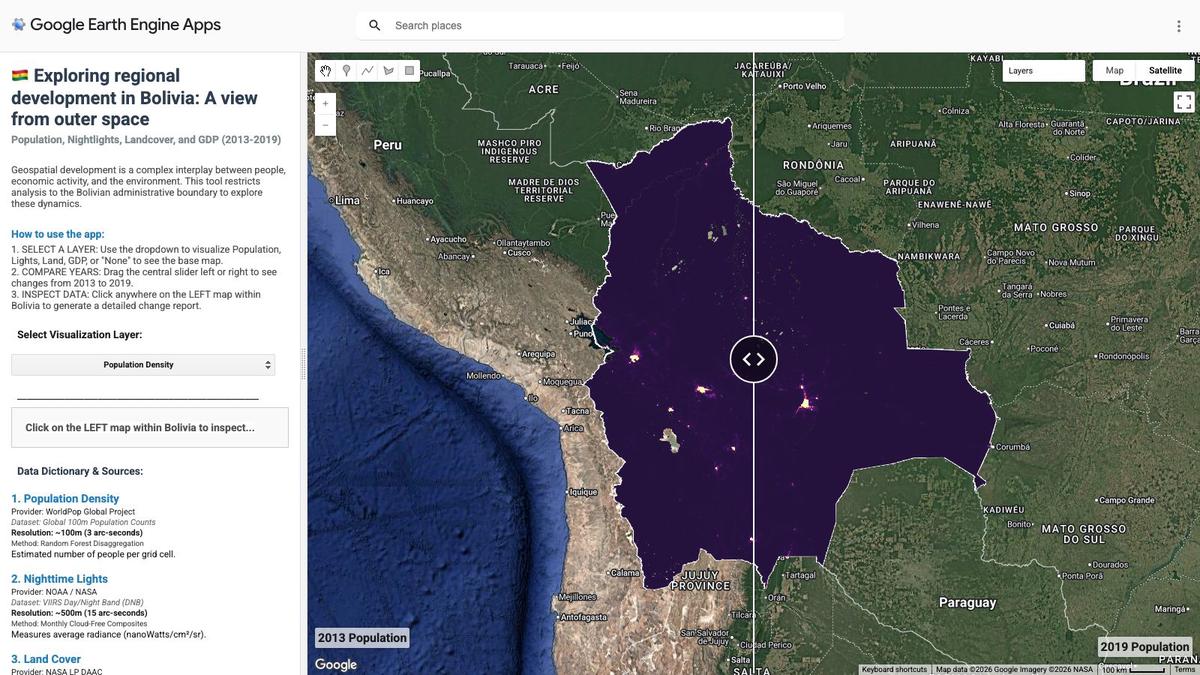
Aplicación interactiva de Google Earth Engine.
Aplicación interactiva de Google Earth Engine.
Aplicación interactiva de Google Earth Engine.
Aplicación interactiva de Google Earth Engine.
Aplicación interactiva de Google Earth Engine.
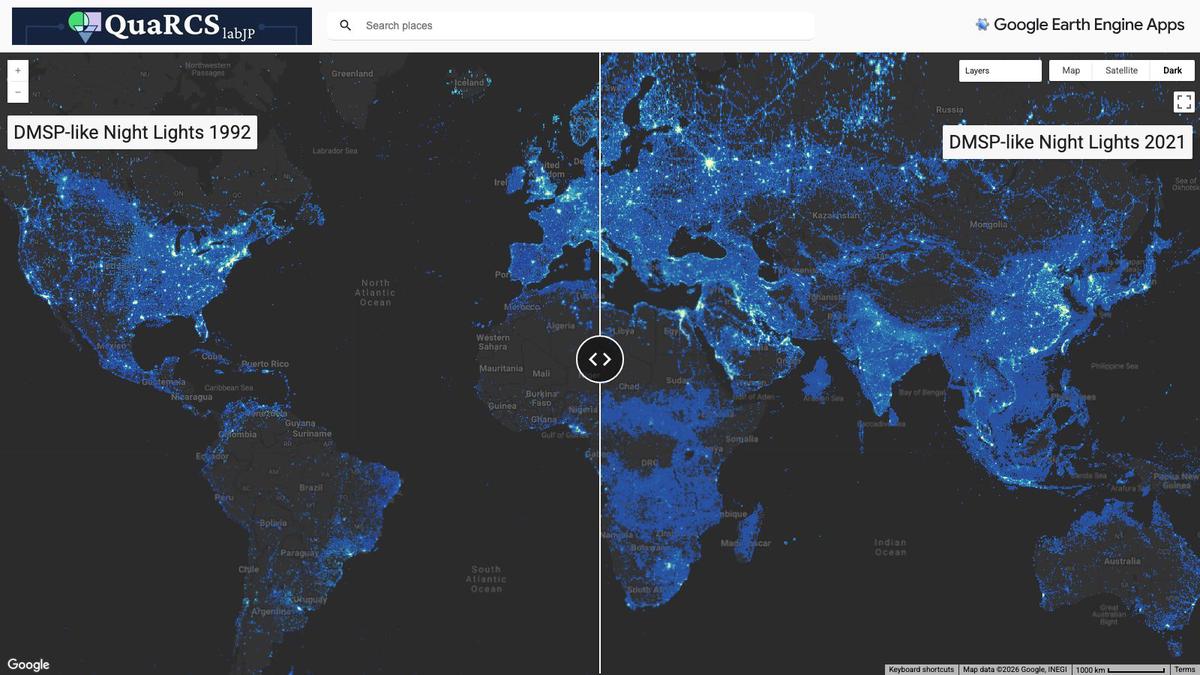
Aplicación interactiva de Google Earth Engine.
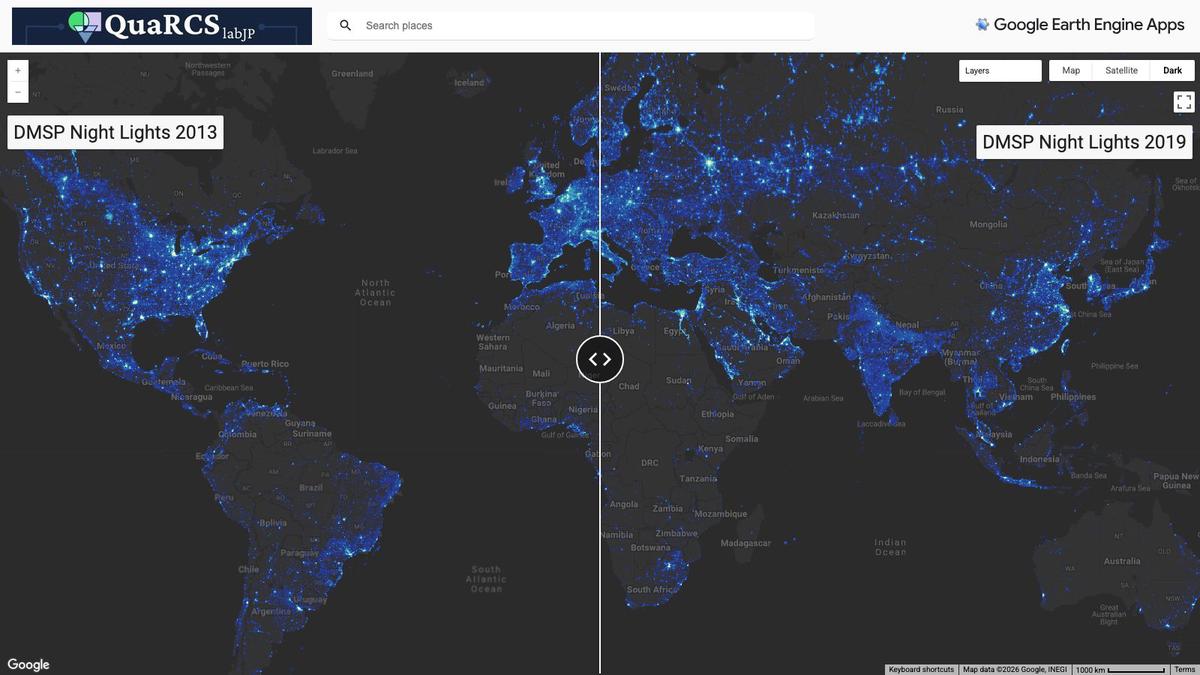
Aplicación interactiva de Google Earth Engine.
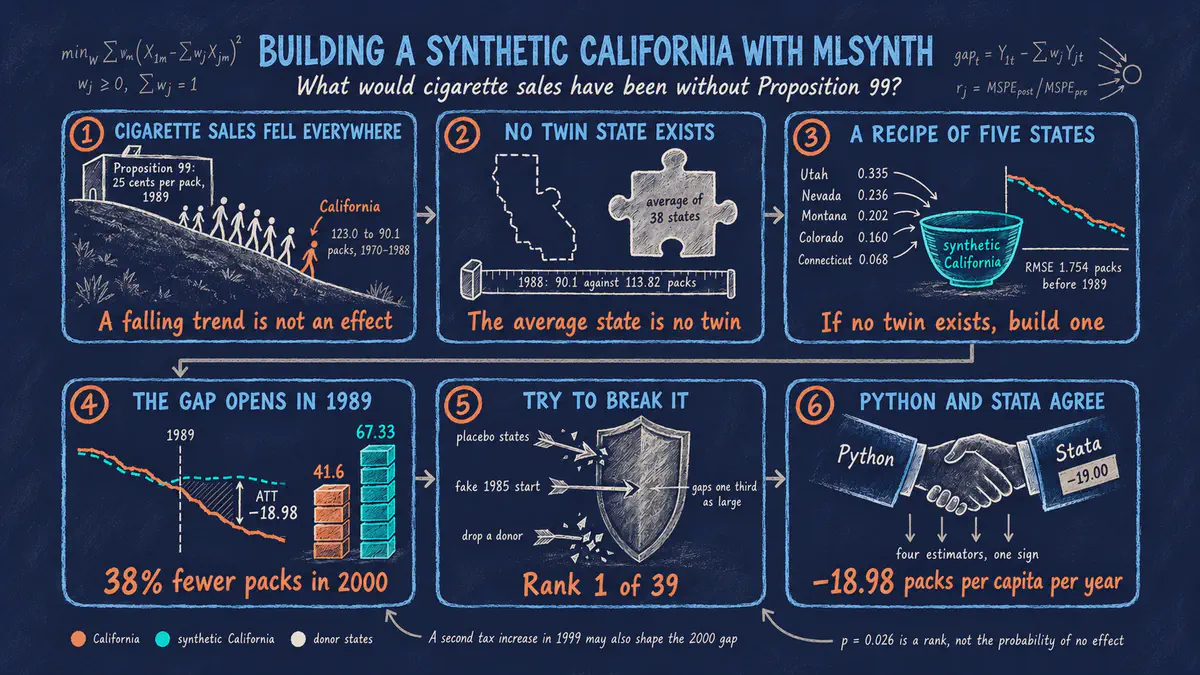
Aprenda el método del control sintético y la librería mlsynth en Python con el caso de la Proposición 99 de California sobre el tabaco. El tutorial construye una California sintética a partir de cinco estados donantes e interpreta sus pesos y su balance de predictores. Luego pone a prueba el resultado con placebos en el espacio, placebos en el tiempo y reestimaciones que excluyen un donante a la vez. Además, replica la edición en Stata y compara cuatro estimadores de mlsynth.
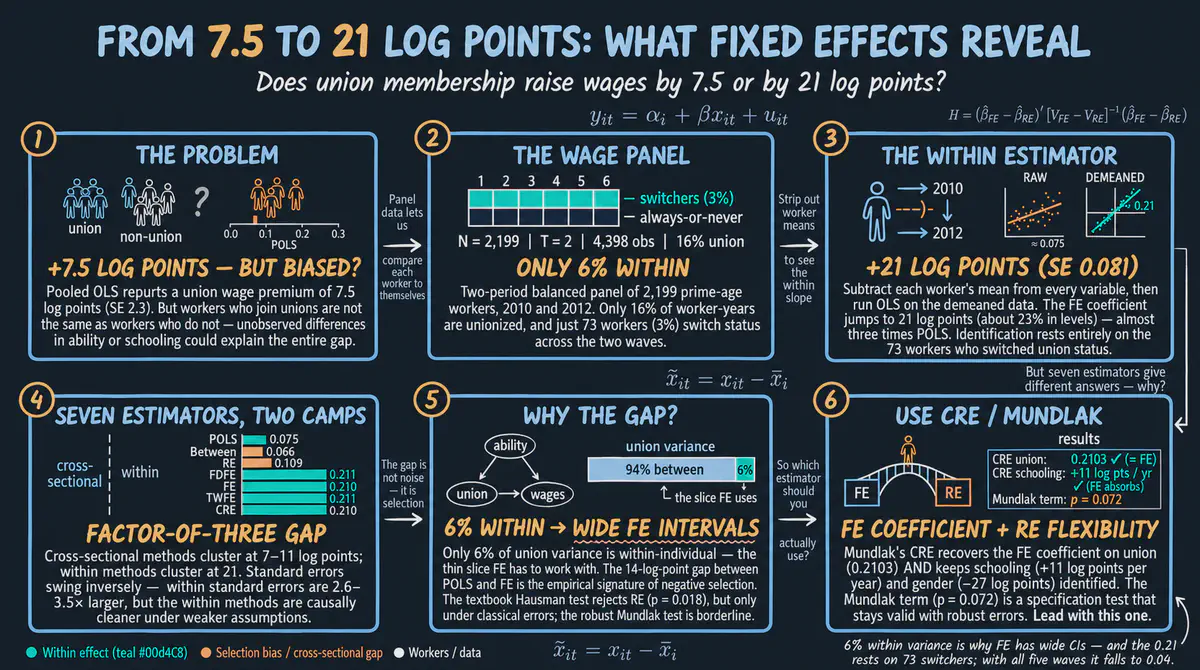
Un recorrido accesible para principiantes por siete estimadores de datos de panel, desde MCO agrupados hasta efectos aleatorios correlacionados (Mundlak), aplicados a un panel de salarios de trabajadores de dos periodos. Preguntas de predicción, dos demostraciones breves, un laboratorio interactivo y ejercicios resueltos muestran por qué los estimadores intra-individuo casi triplican la prima salarial sindical.
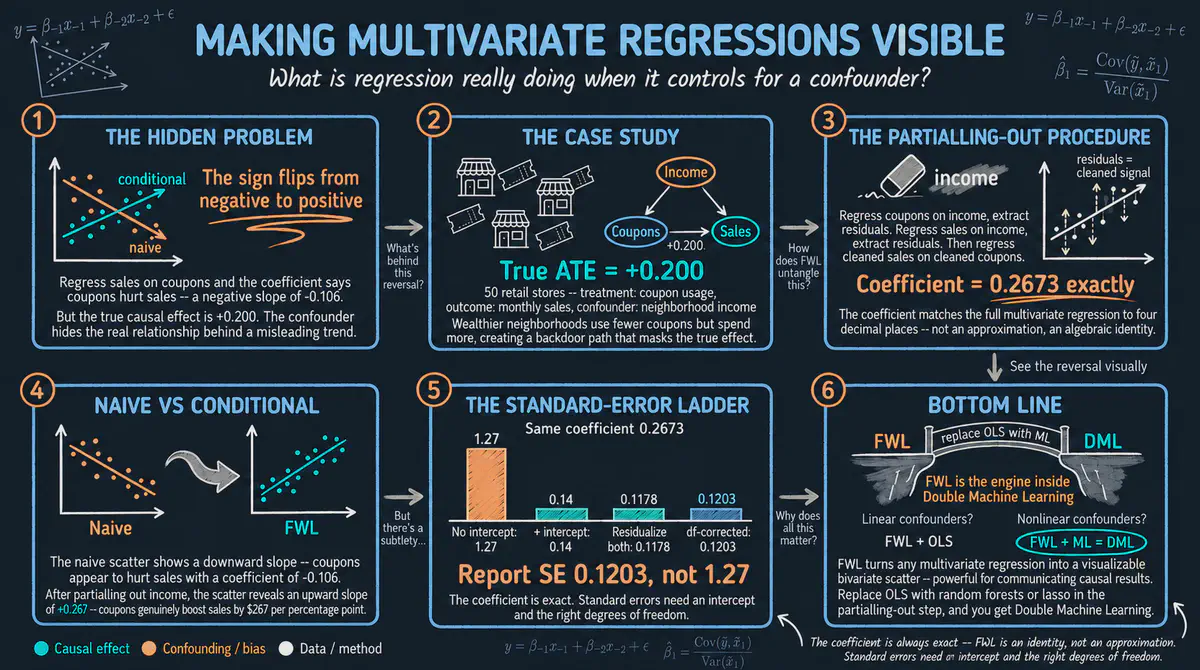
Comprensión del teorema de Frisch-Waugh-Lovell para aislar relaciones causales descontando los factores de confusión en una promoción simulada de cupones en una cadena de comida rápida, con un apéndice que extiende FWL a datos de panel.
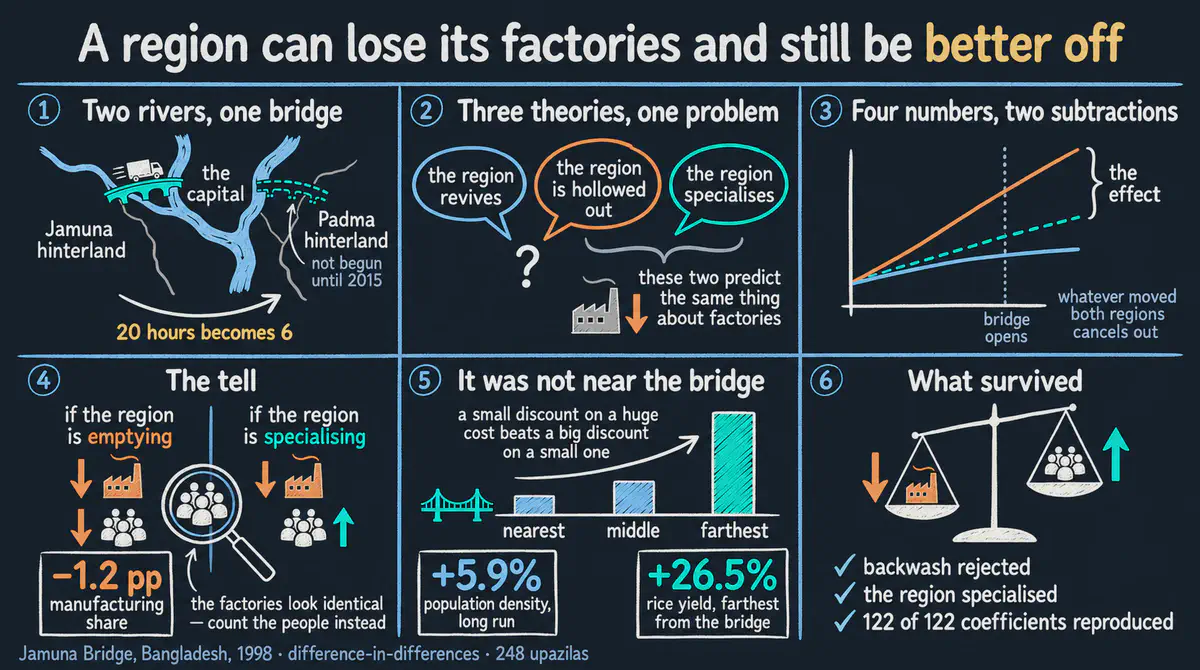
En junio de 1998, un puente de 4.8 kilómetros sobre el río Jamuna conectó a 26 millones de bangladesíes aislados con Daca y redujo a la mitad los costos de flete. Este tutorial reconstruye desde cero, en Python, la evaluación por diferencias en diferencias de ese puente, utilizando como grupo de comparación al hinterland del Padma, una región simétrica que quedó aislada por un río cuyo propio puente no se inició sino hasta 2015. Enseña la lógica 2x2, las tendencias paralelas, los efectos fijos de dos vías, los estudios de eventos y el análisis honesto de sensibilidad sobre luces nocturnas satelitales, y luego aplica la misma maquinaria a las participaciones sectoriales del censo, los rendimientos de arroz y un placebo de bienes públicos. Los dos estimadores doblemente robustos del artículo original se reconstruyen a mano en NumPy y se ejecutan tanto en diff-diff como en pyfixest. Los 122 coeficientes publicados se auditan junto a la replicación, y se documentan por completo los defectos hallados dentro del paquete de Stata distribuido.
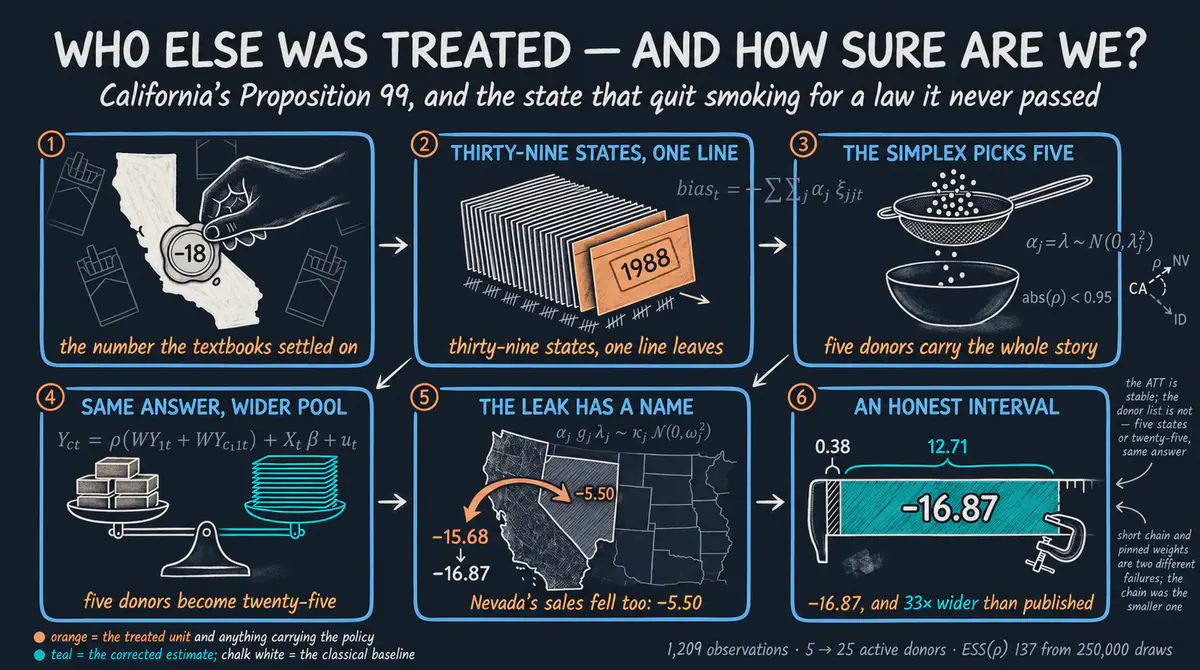
Una introducción desde cero al método de control sintético en Python, construida sobre el caso de la Proposición 99 de California y organizada en tres etapas: el símplex clásico de Abadie, Diamond y Hainmueller; una distribución previa horseshoe que permite que sean los datos, y no una restricción, los que elijan los estados donantes; y el modelo espacial bayesiano de Sakaguchi y Tagawa, que abandona el supuesto SUTVA sobre el grupo de donantes y pregunta quién más resultó tratado. Cada ecuación se deriva y se vincula con el código que la implementa, usando las librerías scspill y mlsynth. El resultado para California sobrevive a todas las relajaciones del modelo. La afirmación de que el grupo de donantes estaba limpio, no.
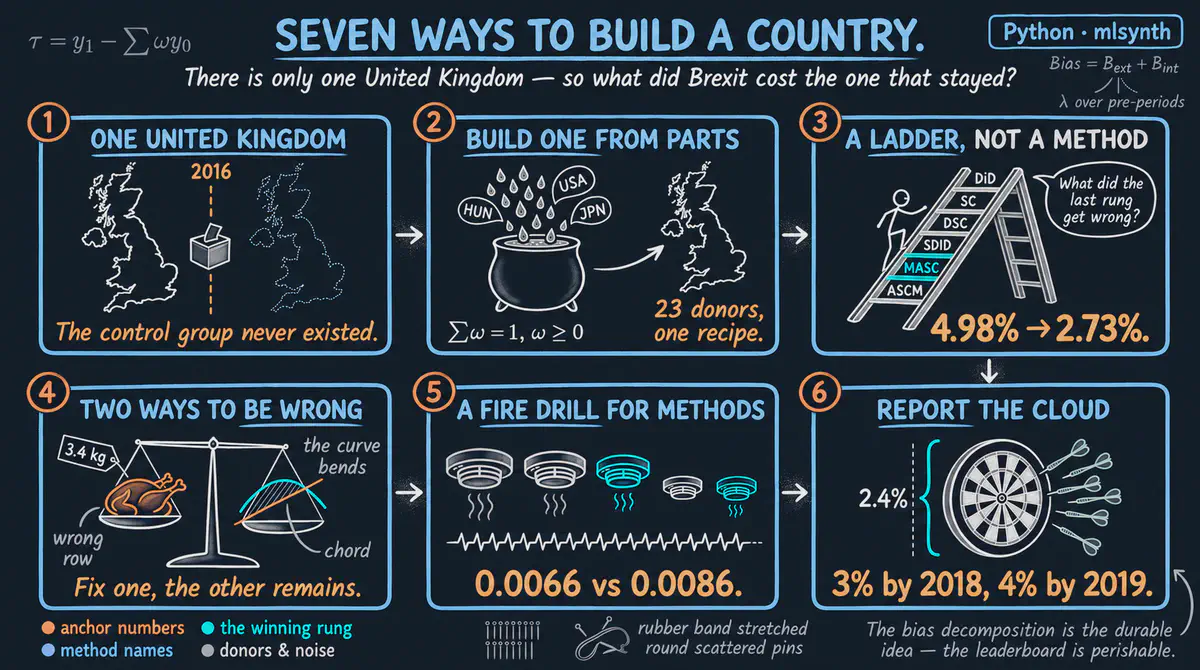
Una introducción cuidadosa a mlsynth, la librería de Python que reúne toda la familia de estimadores de control sintético para una sola unidad tratada detrás de una única interfaz de configuración. Recorremos la escalera completa —diferencias en diferencias, control sintético, control sintético centrado, diferencias en diferencias sintéticas en sus tres variantes, MASC y control sintético aumentado— con una clase de mlsynth por peldaño, explicando qué hace cada opción y dónde los valores por defecto entregan silenciosamente un estimador distinto. El caso de estudio es el referéndum del Brexit de 2016 y su costo para el PIB del Reino Unido.
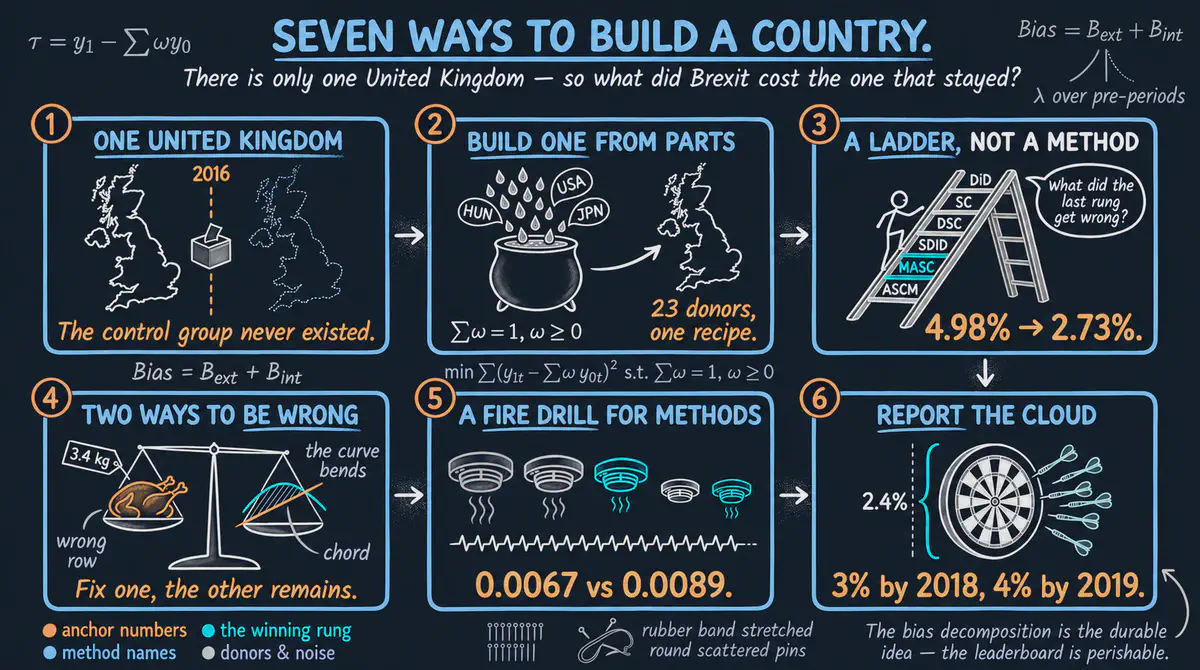
Un recorrido pedagógico por la escalera completa de estimadores de control sintético para una sola unidad tratada: diferencias en diferencias, control sintético, control sintético centrado (DSC), diferencias en diferencias sintéticas (SDID) en sus tres variantes, MASC y control sintético aumentado. Cada método se programa primero desde cero y después se ejecuta con su paquete, sobre el PIB real trimestral de 24 economías de la OCDE entre 1995 y 2020. Incluye hojas de referencia rápida en R, Stata y Python.
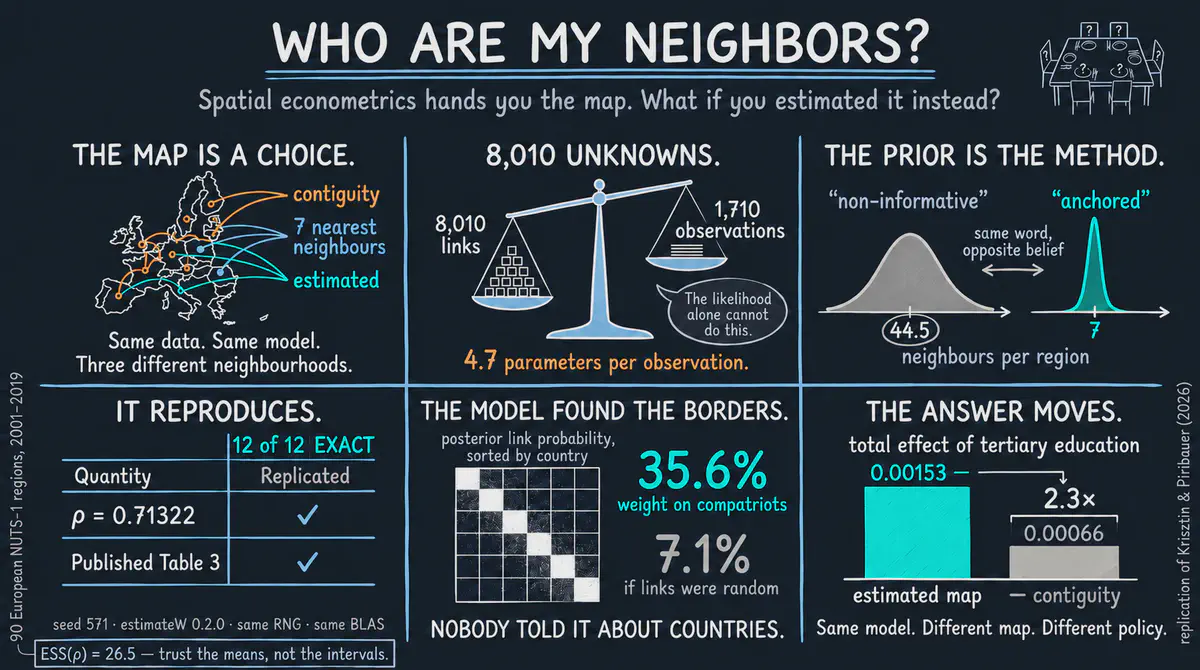
La econometría espacial suele entregarle el mapa de vecindades antes de comenzar. Este tutorial lo estima a partir de los datos, con el paquete estimateW aplicado a 90 regiones NUTS-1 europeas, 2001-2019.
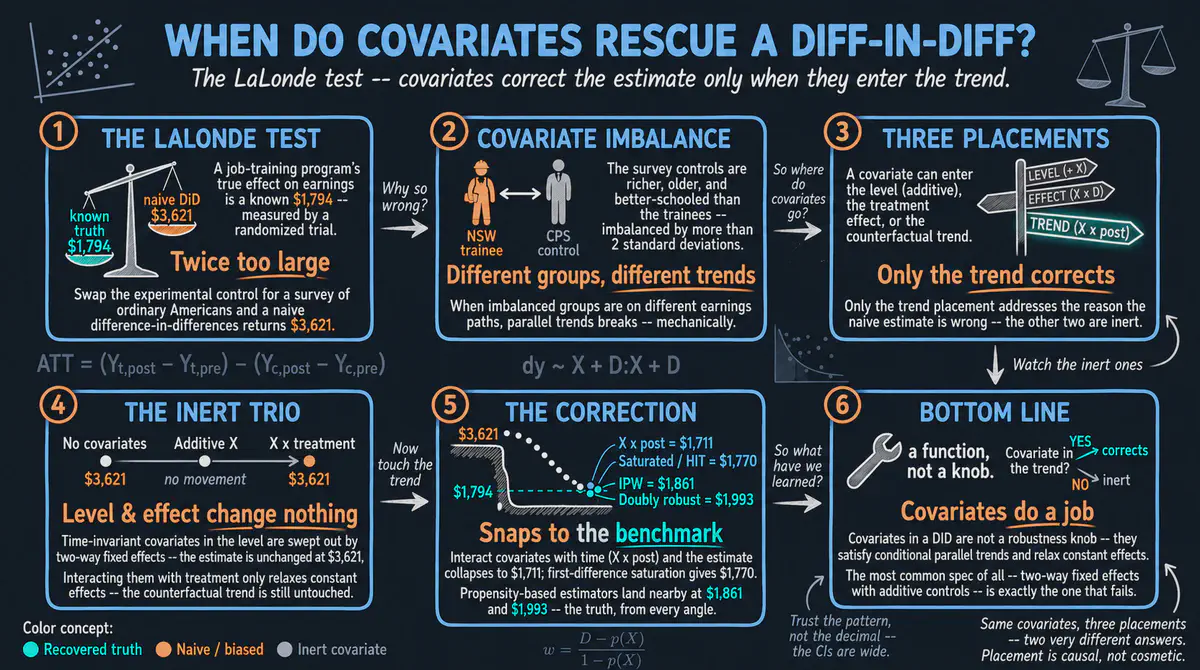
Reproducción de la prueba de LaLonde de Scott Cunningham en Python: en diferencias en diferencias, las covariables solo rescatan el ATT cuando entran en la tendencia contrafactual del grupo de control, recuperando el valor de referencia experimental de $1,794 a partir de un ingenuo $3,621.
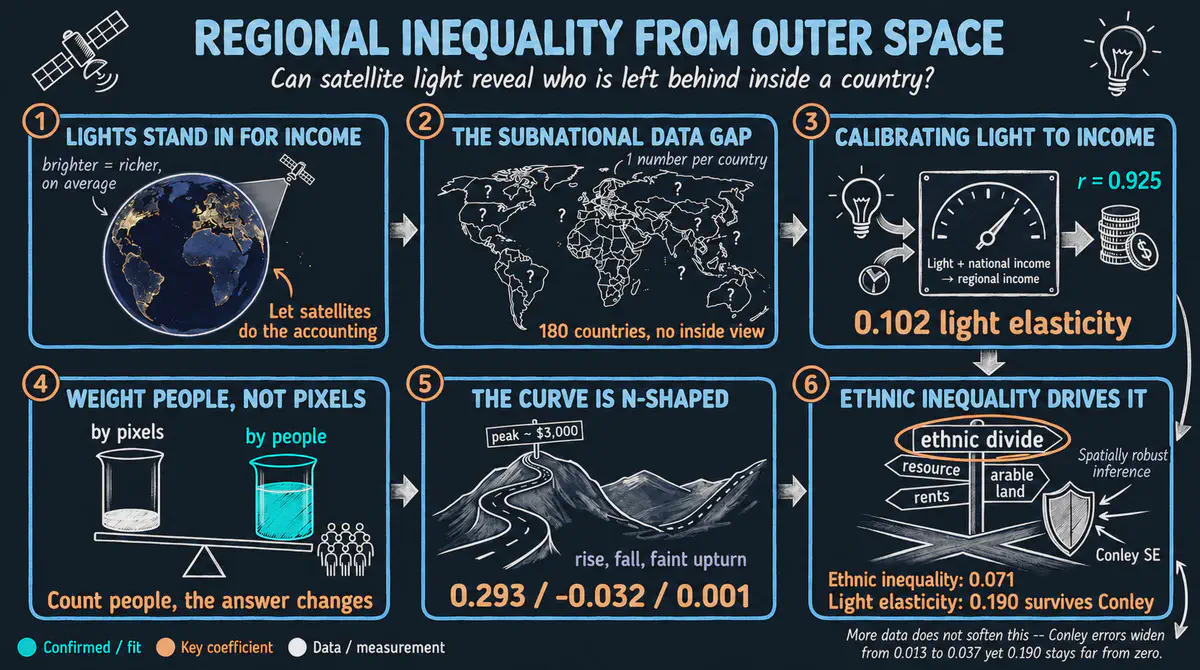
Una réplica integral y didáctica en Python de Lessmann y Seidel (2017): convertir las luces nocturnas satelitales en PIB regional predicho, construir desde cero cinco índices de desigualdad ponderados por población, explorar la dinámica de la desigualdad regional entre países y estimar la curva de Kuznets regional, sus determinantes y una verificación de robustez espacial de Conley (HAC) con PyFixest.
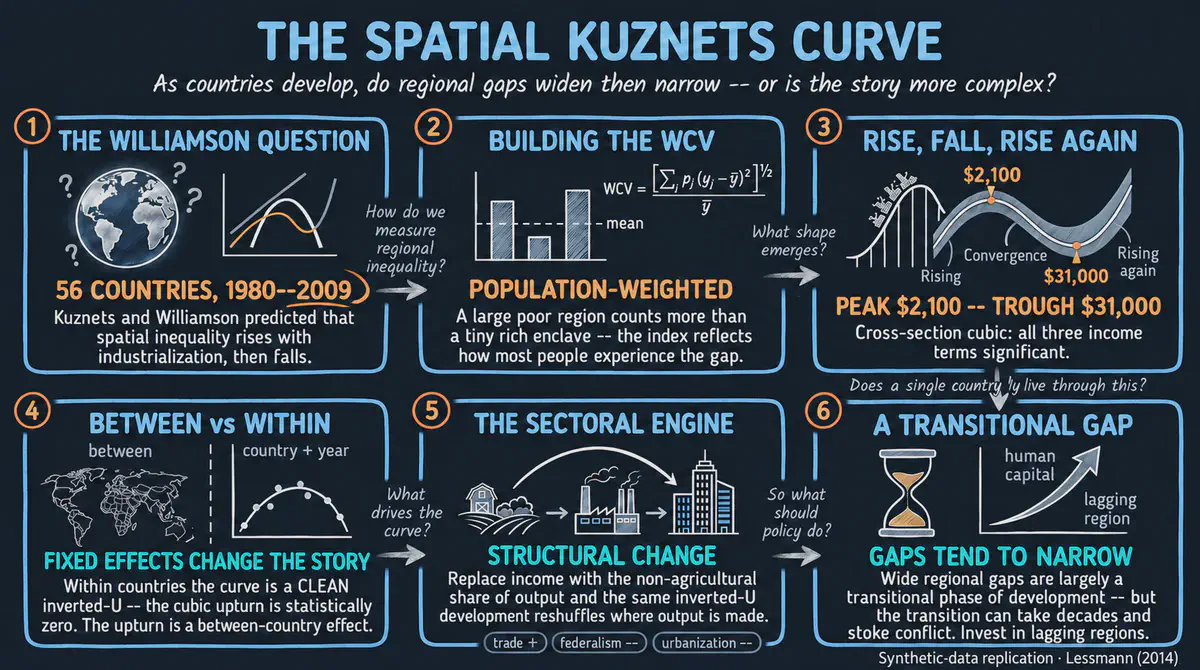
Una replicación en R, accesible para principiantes, de Lessmann (2014) sobre la curva de Kuznets espacial: se construye el coeficiente de variación ponderado a partir de datos regionales simulados y luego se estima la U invertida con MCO de corte transversal, efectos fijos bidireccionales en fixest y los estimadores semiparamétricos de Robinson y Baltagi–Li.
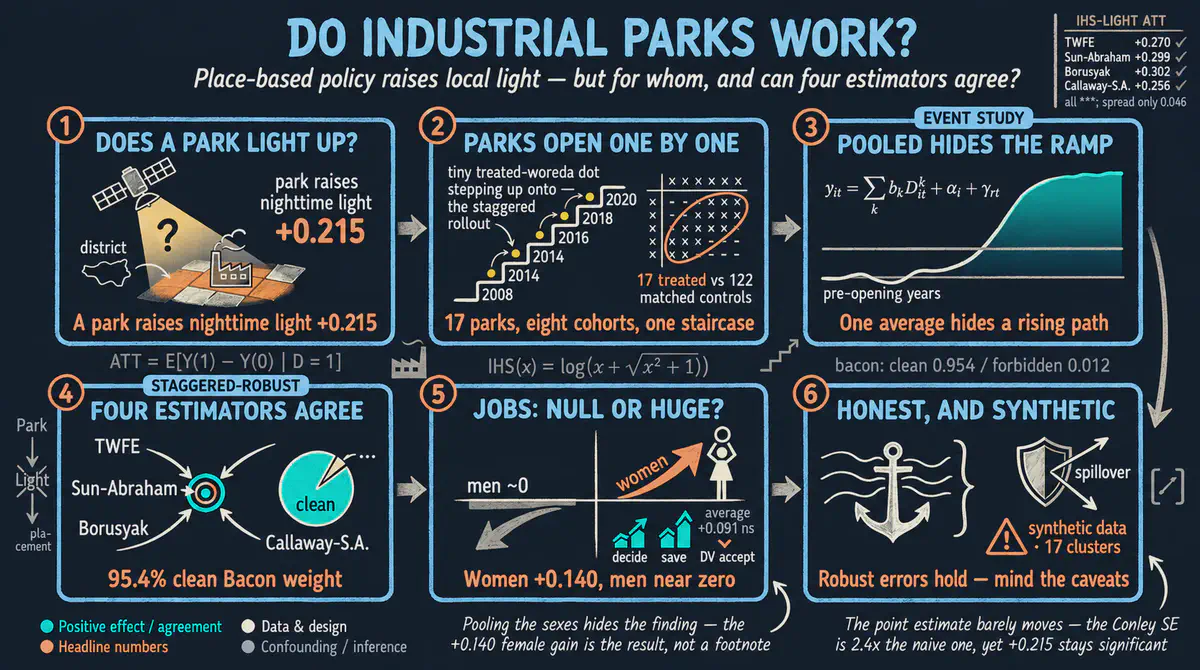
¿Elevan los parques industriales la actividad económica local, y para quién? Una evaluación para principiantes con diferencias en diferencias escalonadas de los parques industriales etíopes en Python, que replica a Huang, Wang y Xu (2026) sobre datos sintéticos calibrados: TWFE y un estudio de eventos con pyfixest, los estimadores modernos de Sun-Abraham, Borusyak/Gardner y Callaway-Sant’Anna más una descomposición de Goodman-Bacon con diff-diff, DiD de sección cruzada repetida y ponderada por encuesta sobre el bienestar de los hogares y el empoderamiento de las mujeres en la DHS, y errores estándar espaciales de Conley.
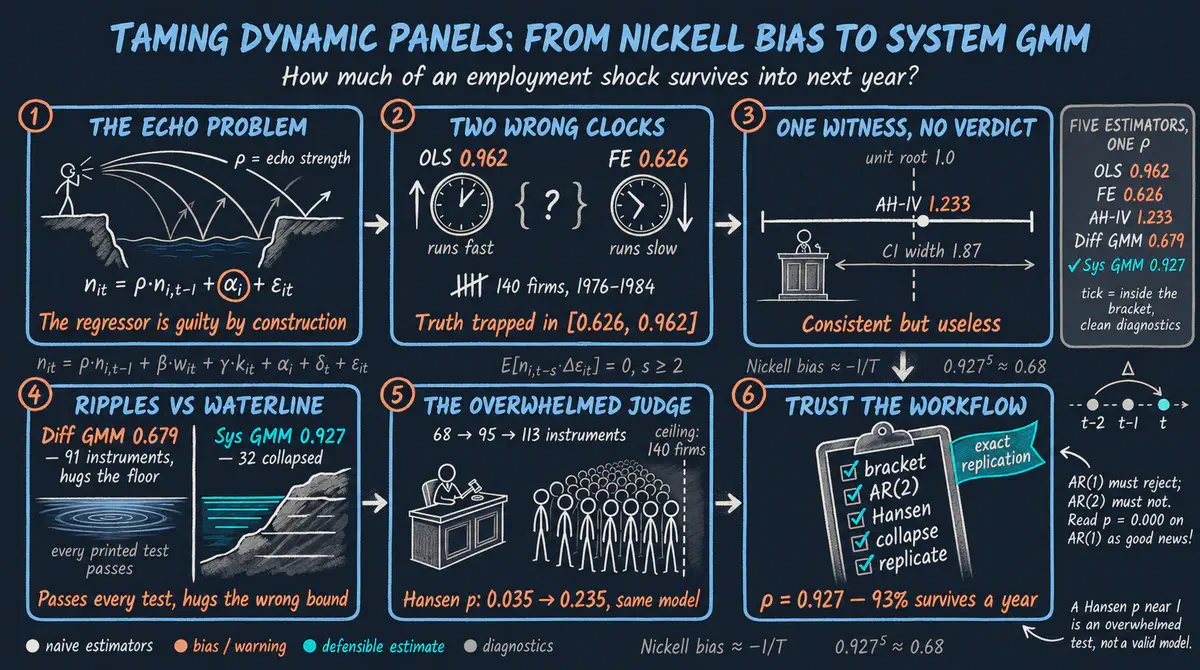
¿Qué tan persistente es el empleo de las empresas? MCO agrupado, efectos fijos, IV de Anderson-Hsiao, GMM en diferencias de Arellano-Bond y GMM en sistema de Blundell-Bond aplicados al clásico panel de 140 empresas del Reino Unido — y cómo los diagnósticos AR(2), de Hansen y de colapso de instrumentos separan la única estimación defendible de cuatro seductoras estimaciones erróneas.
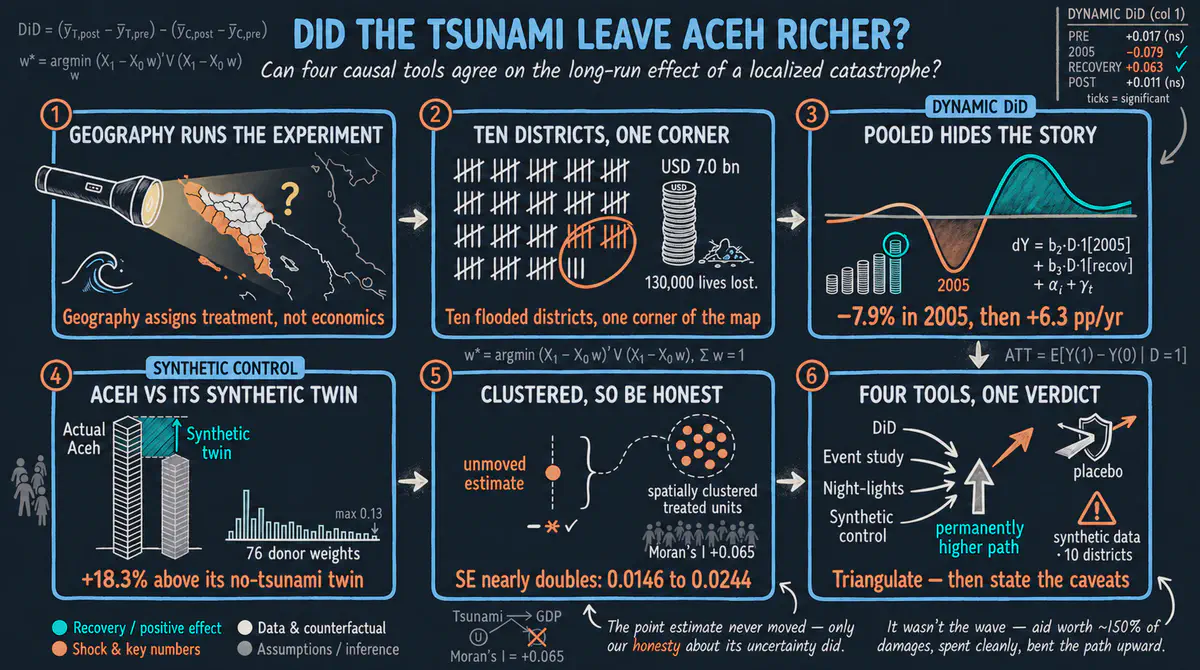
Evalúe el impacto económico de largo plazo de un desastre natural localizado con inferencia causal en Python. Una replicación para principiantes de Heger y Neumayer (2019) sobre el tsunami de Aceh de 2004, con datos sintéticos calibrados: diferencias en diferencias dinámicas con pyfixest, un estudio de eventos con diff-diff, una respuesta a la dosis de luces nocturnas, control sintético con mlsynth y errores estándar espaciales de Conley.
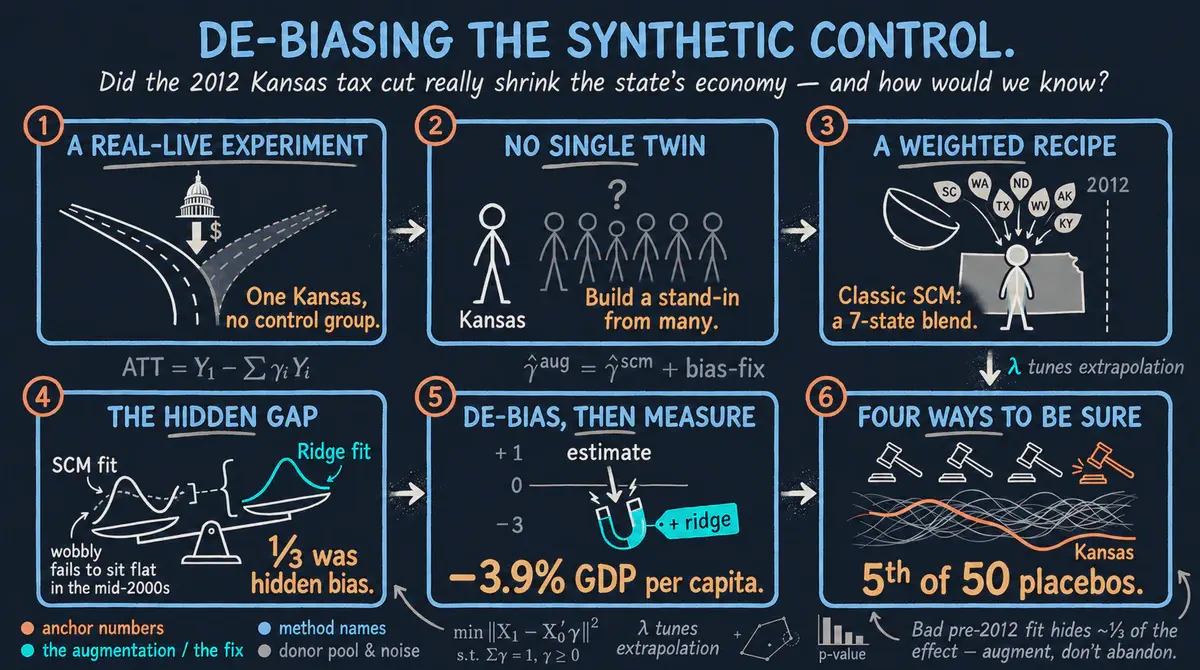
Un tutorial introductorio y centrado en la intuición sobre el método de control sintético aumentado (ASCM) para una sola unidad tratada: la estimación del efecto de los recortes de impuestos de Kansas de 2012 sobre el PIB per cápita con el paquete augsynth, del control sintético clásico a la aumentación por ridge, con un recorrido cuidadoso por cuatro formas de hacer inferencia.
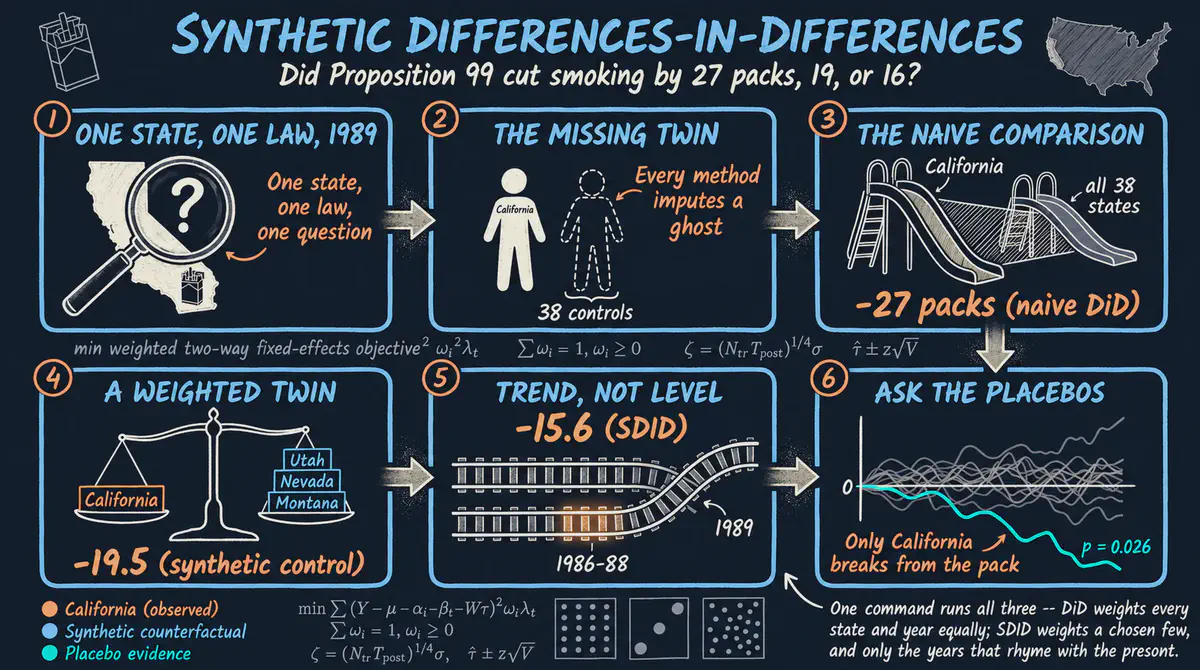
Introducción y derivación del método de diferencias en diferencias sintéticas, con una aplicación a la Proposición 99 de California: se compara con las diferencias en diferencias y el control sintético originales (synth2) y se explica cómo realizar inferencia por placebo con una sola unidad tratada.
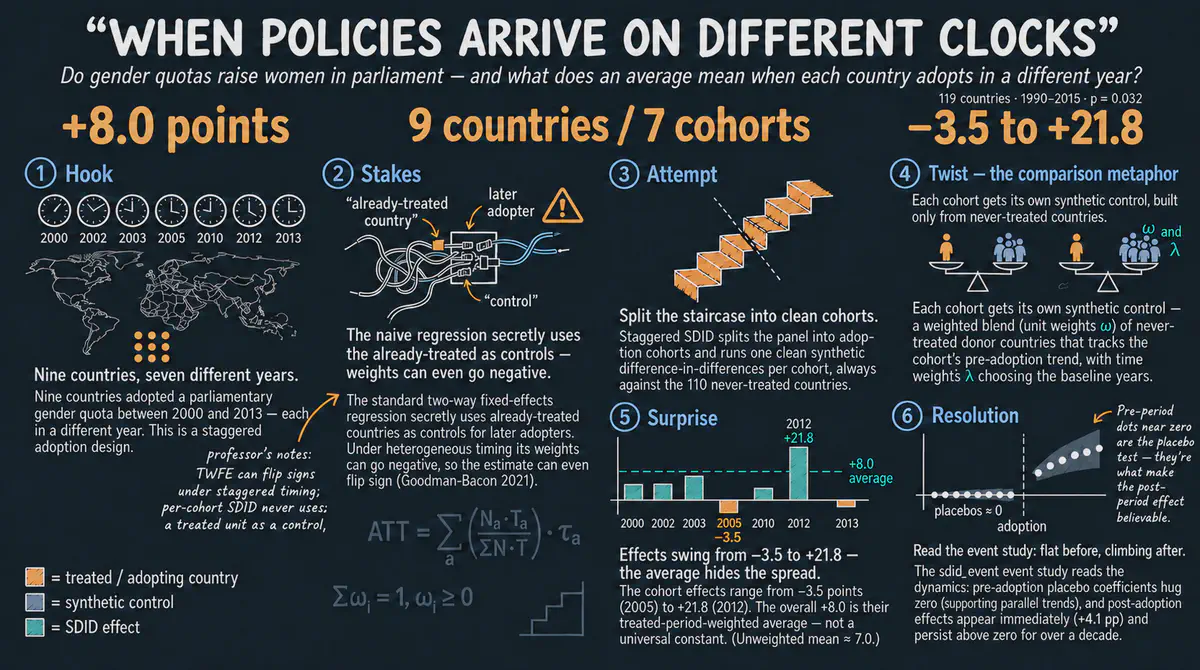
Se extienden las diferencias en diferencias sintéticas al caso de adopción escalonada, en el que las unidades reciben el tratamiento en momentos distintos, y se aplican en Stata a las cuotas de género parlamentarias en 119 países: se deriva el estimador por cohorte, su agregación en el ATT global, el moderno estudio de eventos con sdid_event y la inferencia por bootstrap, jackknife y placebo.
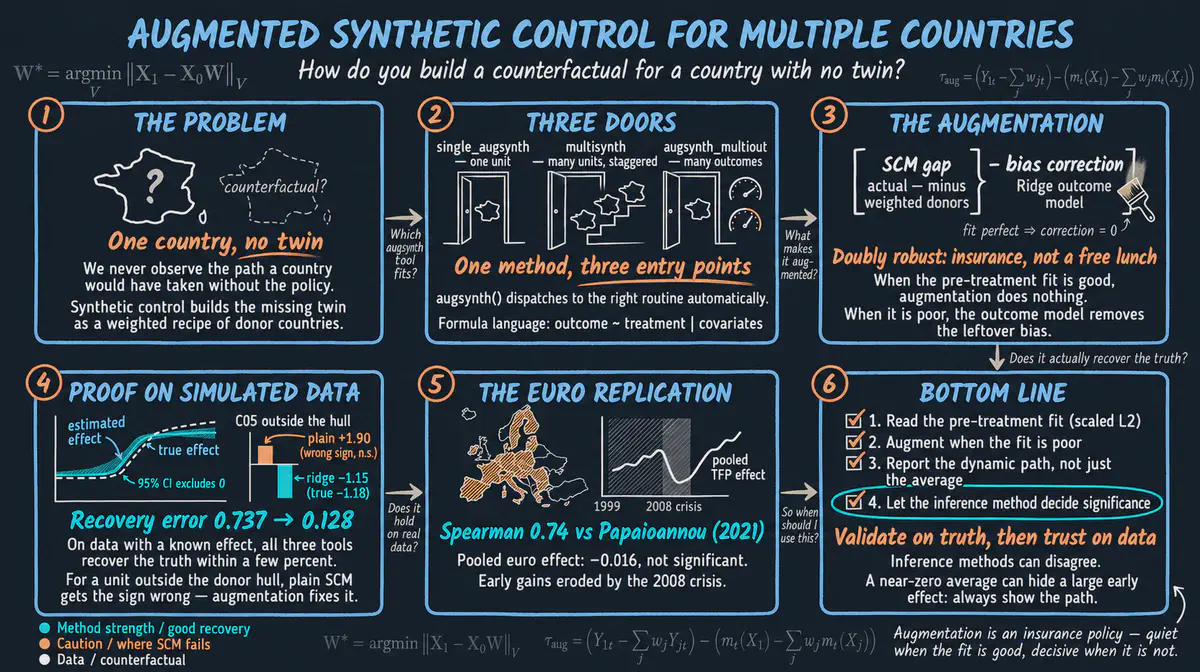
Un recorrido práctico por el método de control sintético aumentado en un entorno multipaís con el paquete augsynth: aprenda single_augsynth, multisynth y augsynth_multiout con datos simulados y luego replique a Papaioannou (2021) sobre la unión monetaria europea y la convergencia de la productividad.
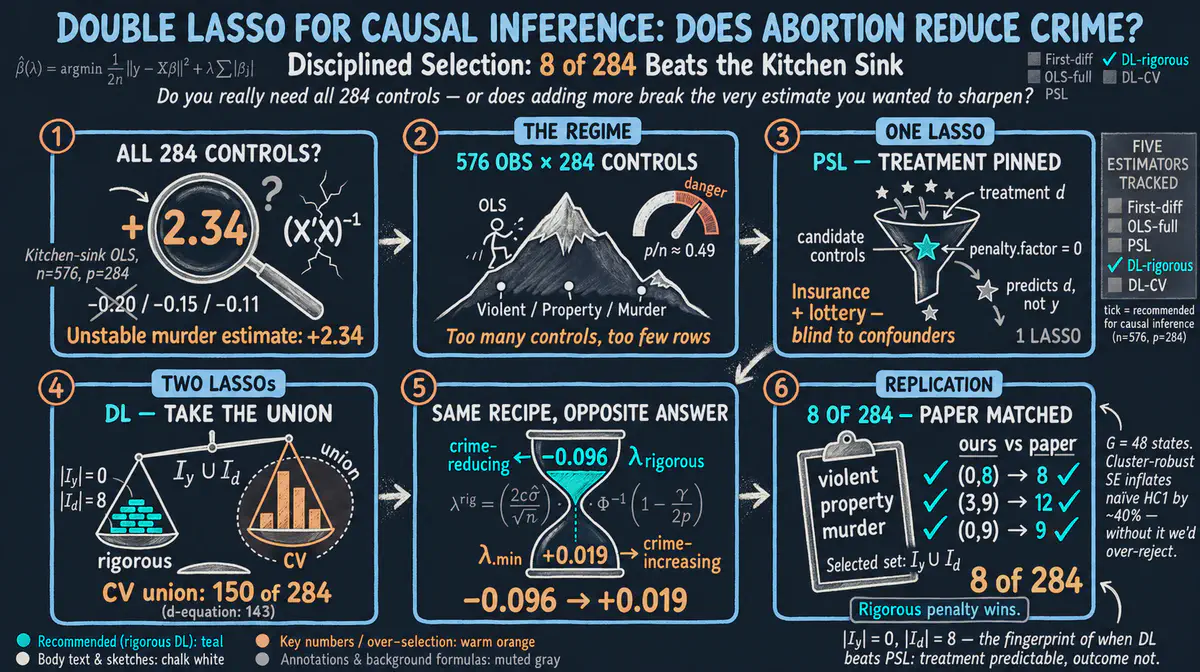
Un recorrido accesible por el Doble LASSO para inferencia causal, replicando el análisis de Fitzgerald, Lattimore, Robinson y Zhu (2026) sobre la cuestión del aborto y la delincuencia de Donohue–Levitt con 284 controles candidatos y errores estándar agrupados por estado.
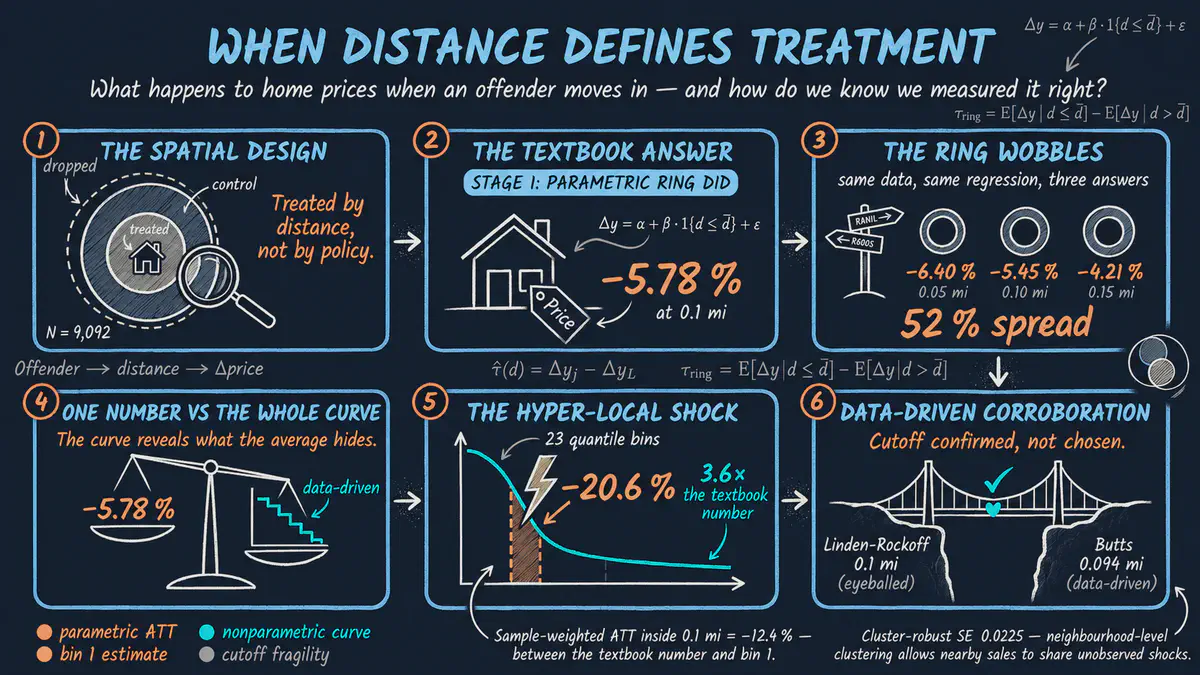
Cuando el ’tratamiento’ es un punto en el espacio, la distancia se convierte en la variable de asignación. Recorremos el DiD de anillos paramétrico y una alternativa no paramétrica basada en datos, primero en un mundo simulado con respuesta conocida y luego en el estudio de precios de vivienda de Linden y Rockoff, y reconciliamos un −5,78 % paramétrico con un −20,6 % no paramétrico.
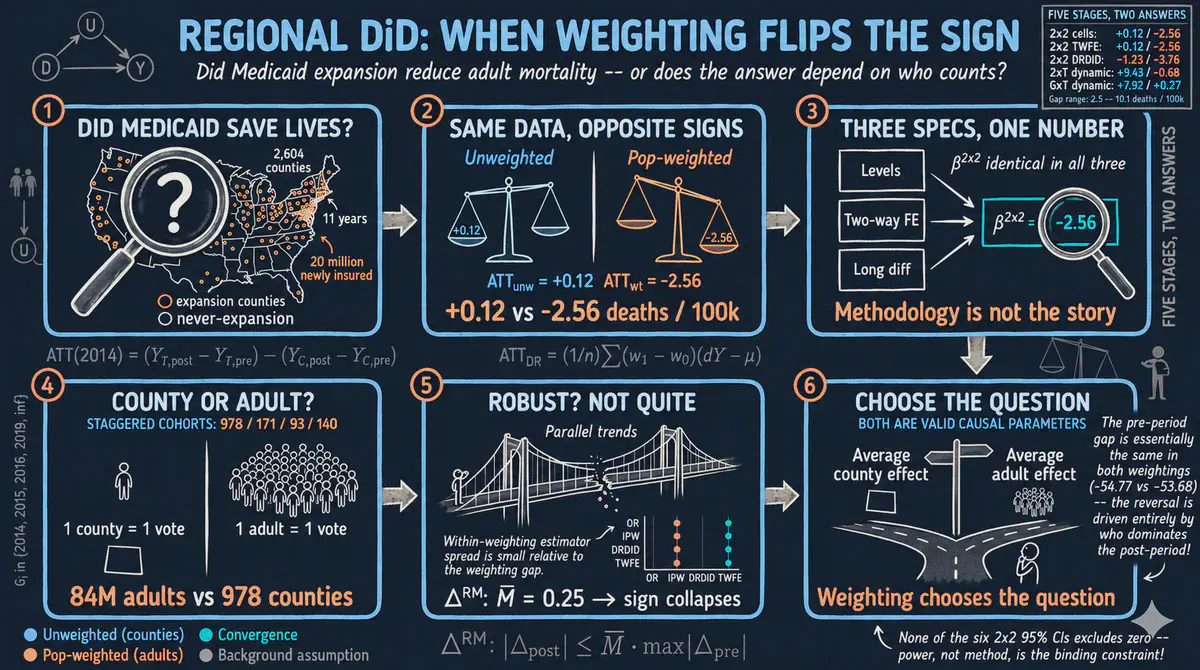
Un estudio de caso sobre la expansión de Medicaid de la Affordable Care Act —pasando por medias de celda 2x2, TWFE, DRDID ajustado por covariables, estudios de eventos escalonados 2xT y de Callaway-Sant’Anna, y la sensibilidad HonestDiD— para mostrar cómo la ponderación poblacional cambia el parámetro objetivo cuando las unidades son regiones de tamaños muy distintos.
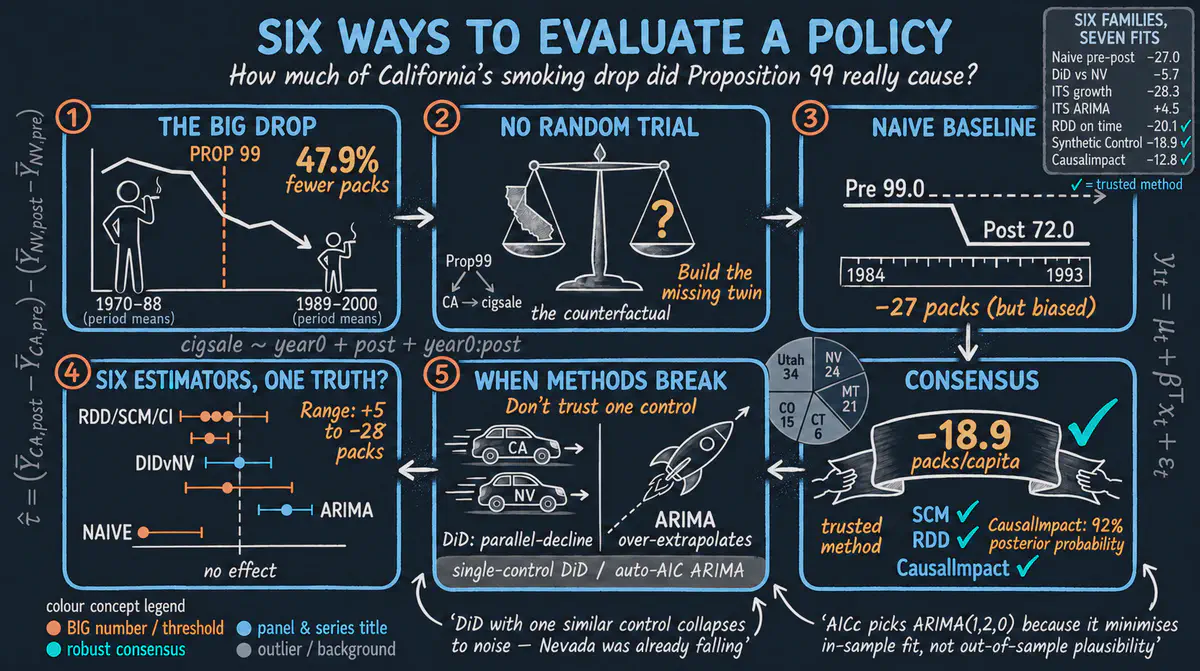
Seis estimadores en un mismo tutorial —pre-post ingenuo, DiD, dos variantes de ITS, RDD temporal, control sintético y CausalImpact— aplicados al impuesto al tabaco de la Proposición 99 de California (1988) para ver cuánto (y dónde) difieren.
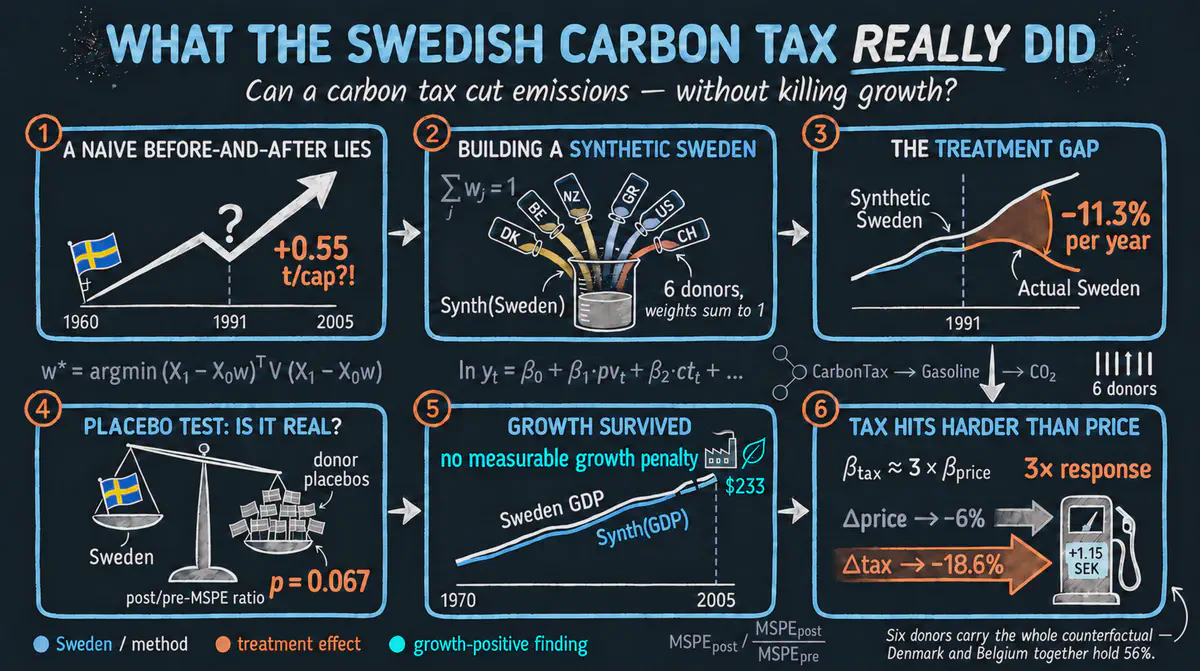
Control sintético e IV en Python — replicando a Andersson (2019) sobre el impuesto al carbono de Suecia y las emisiones de CO2 con pysyncon y pyfixest.
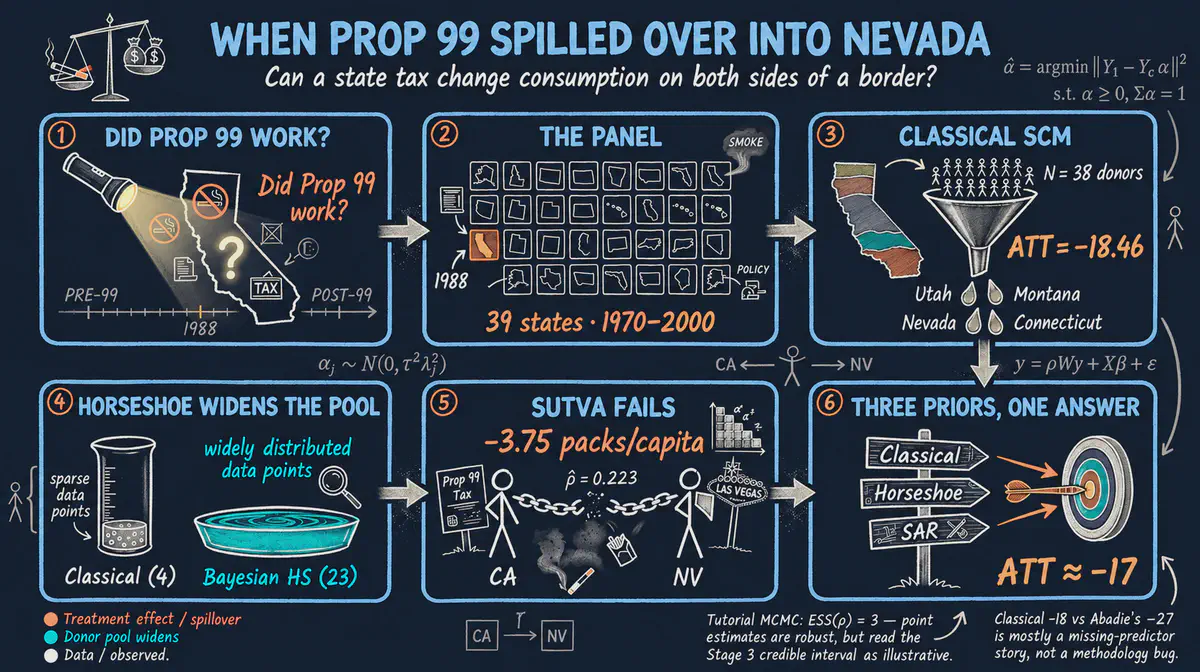
Replicando el estudio de caso del tabaco de California de Sakaguchi y Tagawa en R: tres estimadores, un ATT y un efecto de derrame (spillover) del tamaño de Nevada.
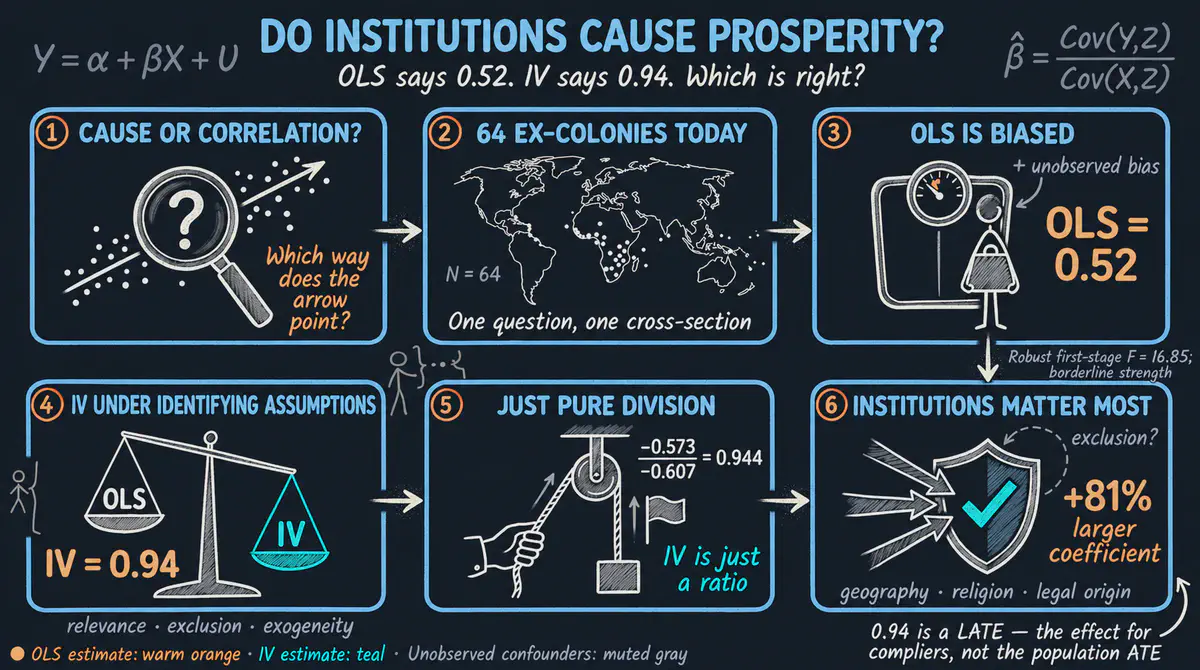
Replique a Acemoglu, Johnson y Robinson (2001) en Python con pyfixest y linearmodels: instrumente las instituciones modernas con la mortalidad de los colonos en 64 ex colonias y aprenda cómo IV recupera un efecto causal que MCO subestima en un 80 por ciento.
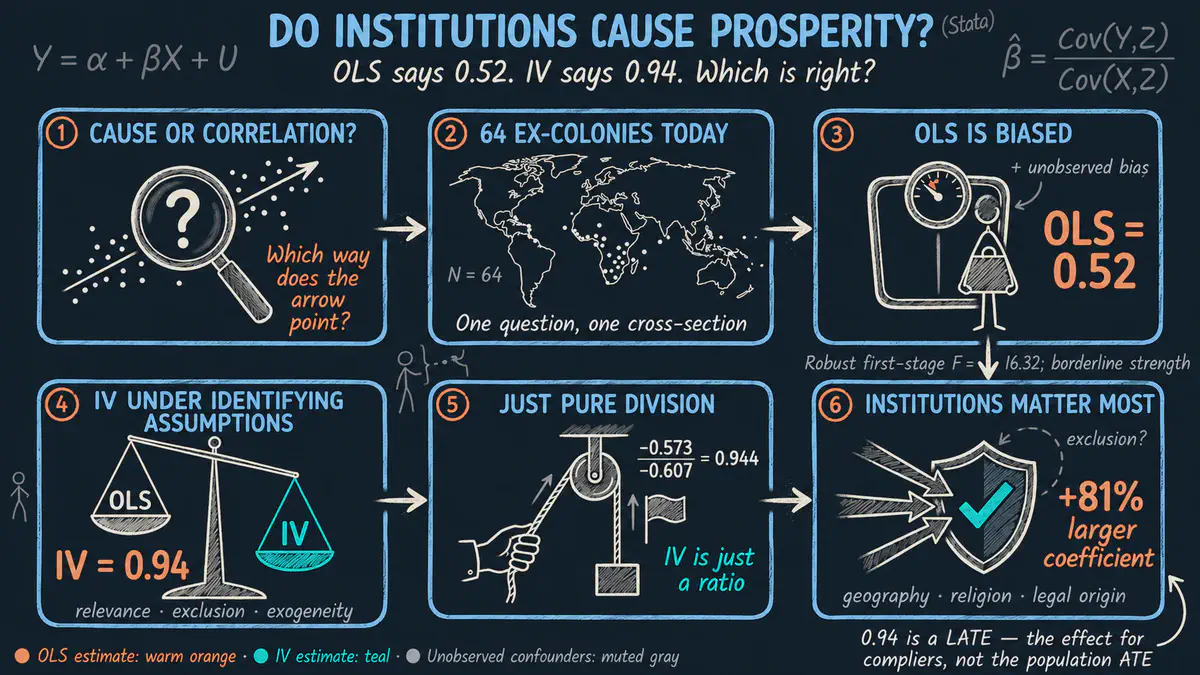
Replique a Acemoglu, Johnson y Robinson (2001) en Stata: instrumente las instituciones modernas con la mortalidad de los colonos en 64 excolonias y descubra cómo el método IV recupera un efecto causal que el MCO subestima en un 80 por ciento.
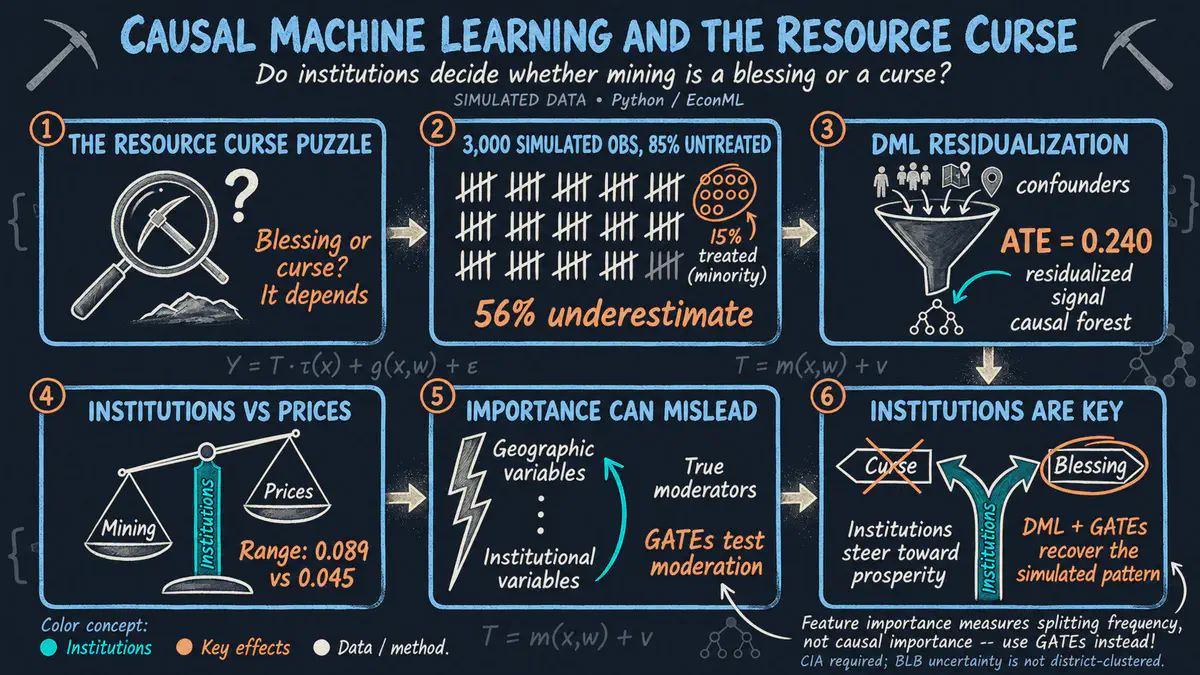
Estime efectos causales heterogéneos de la minería y los precios de los minerales sobre el desarrollo económico mediante el CausalForestDML de EconML con Double Machine Learning, aplicado a datos simulados de la maldición de los recursos.
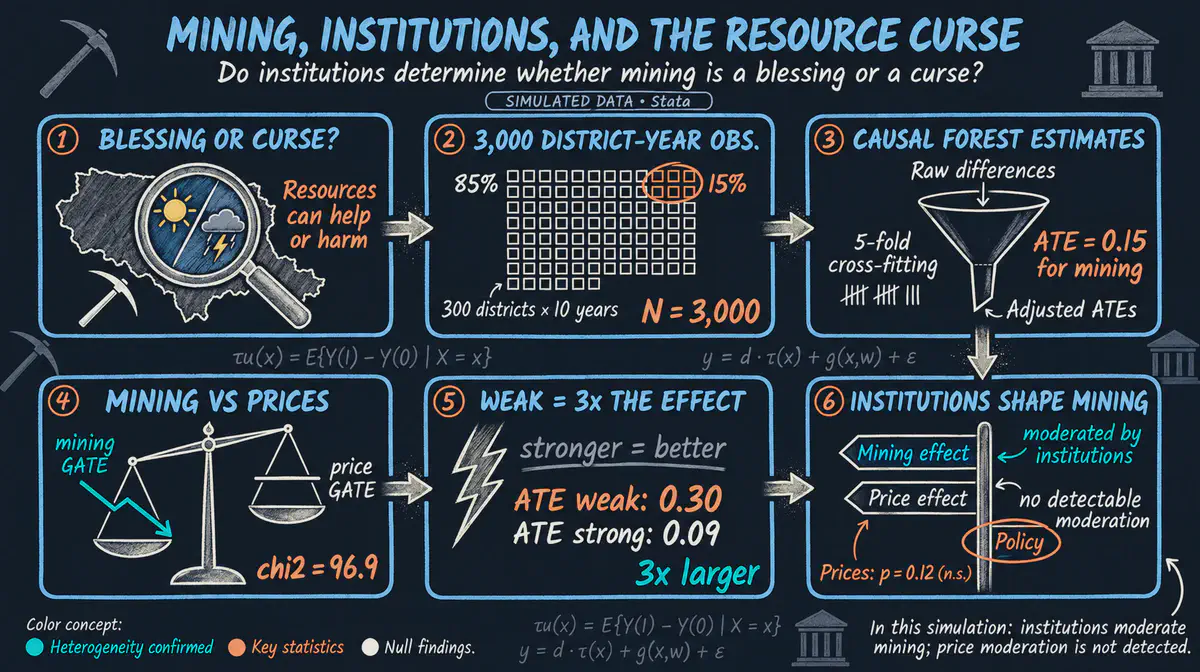
Estime efectos causales heterogéneos de la minería y los precios de los minerales sobre el desarrollo económico usando el comando cate de Stata 19 con tratamiento de múltiples valores mediante comparaciones binarias por pares, aplicado a un conjunto de datos de panel simulado sobre la maldición de los recursos.
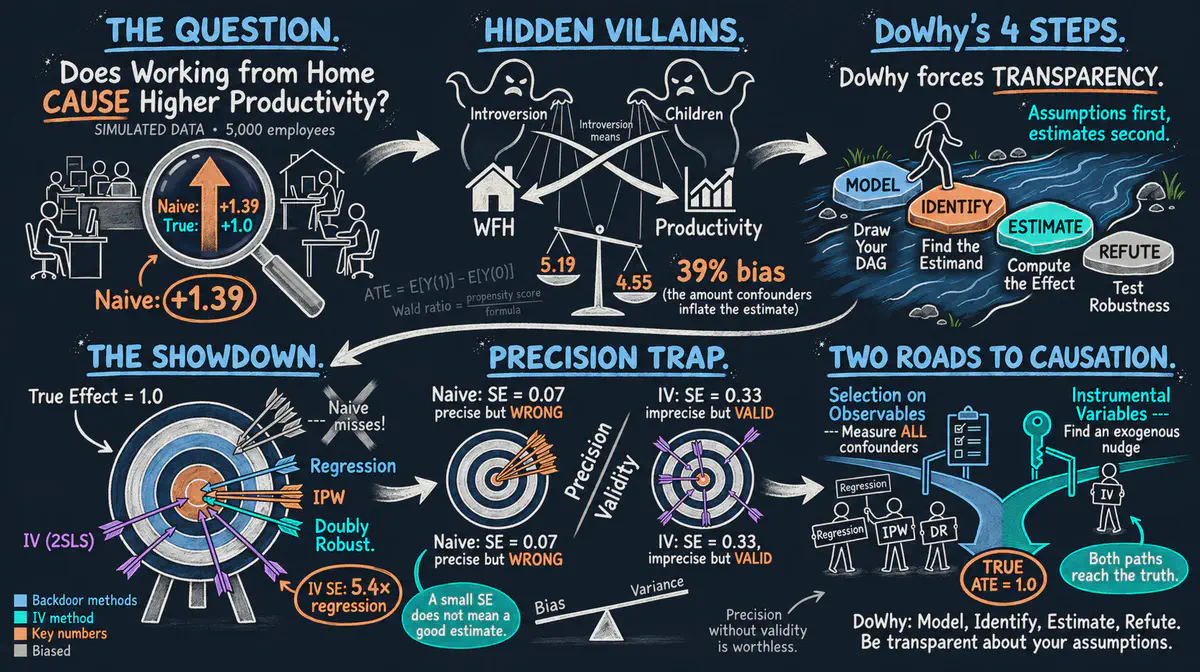
Una introducción accesible para principiantes a la inferencia causal mediante el marco de cuatro pasos de DoWhy con datos observacionales simulados sobre el trabajo desde casa y la productividad.
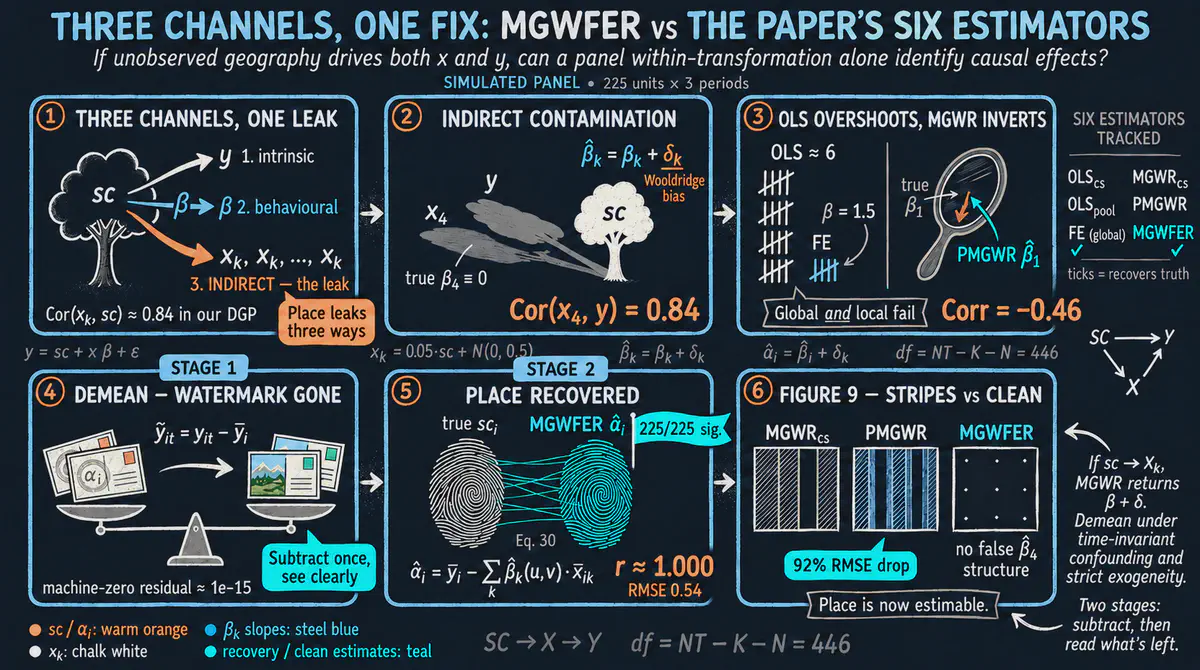
Un tutorial fiel en Python sobre Li y Fotheringham (2026) — utilizando un algoritmo MGWFER de dos etapas para eliminar los factores de confusión espaciales invariantes en el tiempo de la MGWR multiescala y recuperar tanto pendientes espacialmente variables insesgadas como efectos contextuales intrínsecos a partir de datos de panel simulados (225 unidades x 3 periodos).
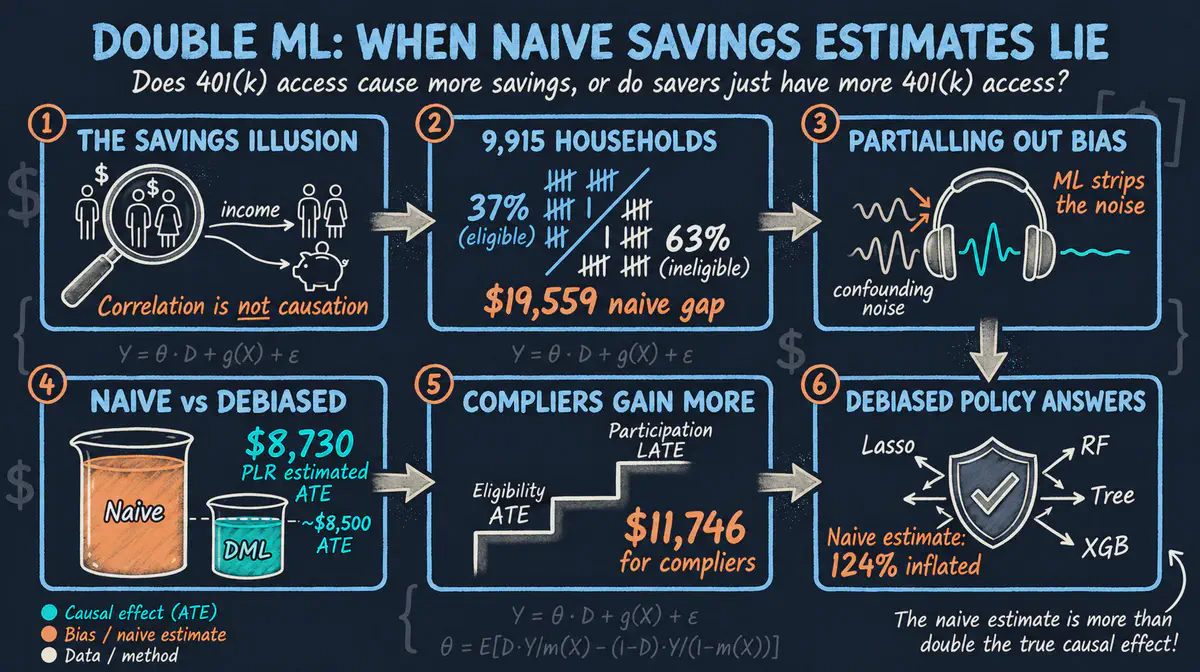
Estimación del efecto causal de la elegibilidad y la participación en planes 401(k) sobre los activos financieros netos mediante tres modelos DoubleML (PLR, IRM, IIVM) con el conjunto de datos de pensiones SIPP de 1991.
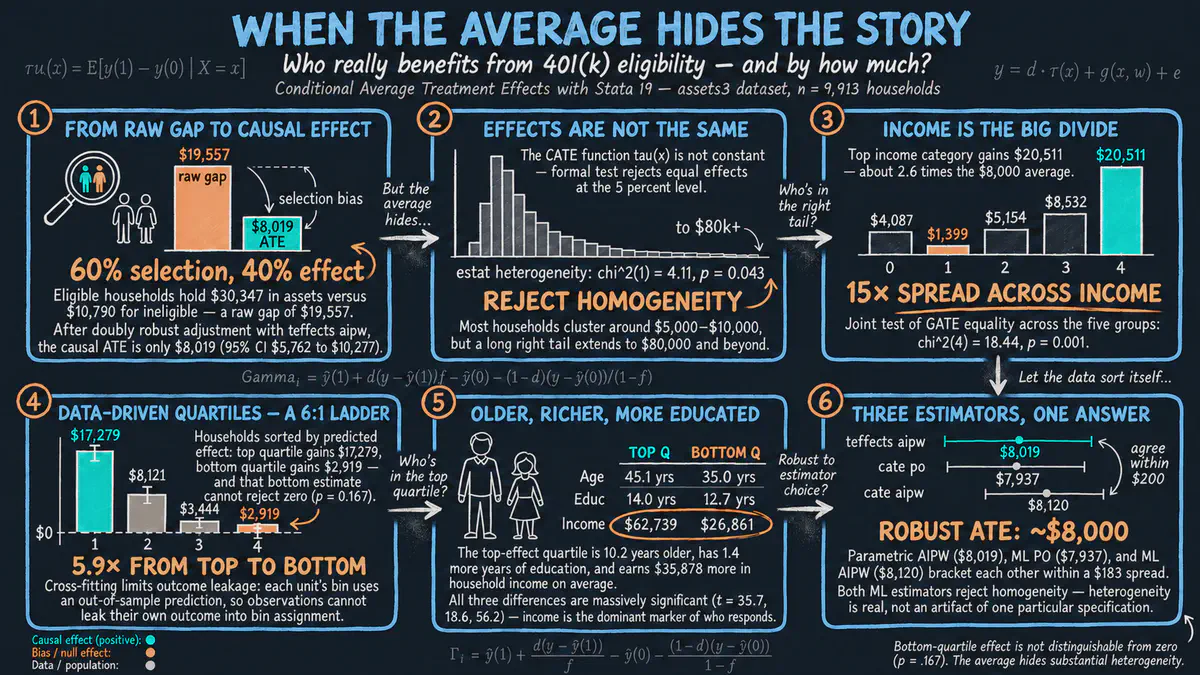
Estime cómo varía entre hogares el efecto de la elegibilidad para el plan 401(k) sobre los activos del hogar usando el nuevo comando cate de Stata 19, con estimadores PO, AIPW, GATE, GATES y de series no paramétricas aplicados al conjunto de datos canónico assets3.
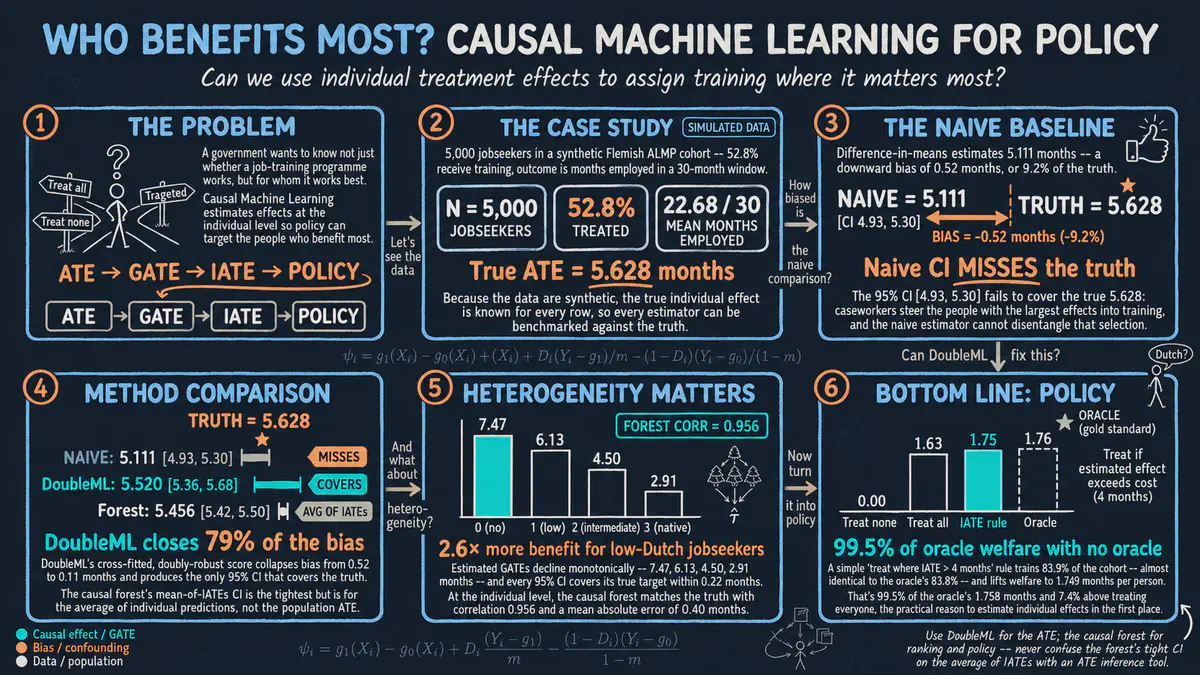
Un recorrido accesible para principiantes por el aprendizaje automático causal —ATE, GATE, IATE y la asignación que maximiza el bienestar— usando DoubleML y EconML sobre una cohorte sintética estilo ALMP de Flandes con efectos verdaderos conocidos.
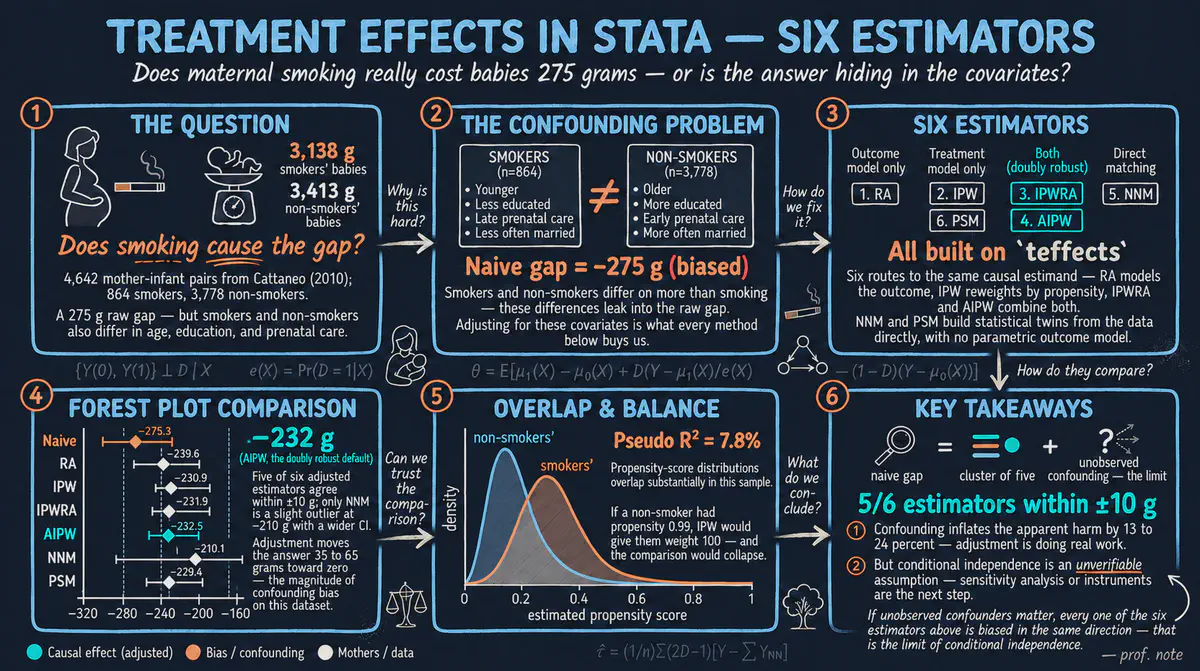
Un recorrido accesible para principiantes por seis estimadores de efectos de tratamiento en Stata — ajuste por regresión, IPW, IPWRA, AIPW, emparejamiento por vecino más cercano y emparejamiento por puntaje de propensión — aplicado al clásico caso del tabaquismo materno y el peso al nacer.
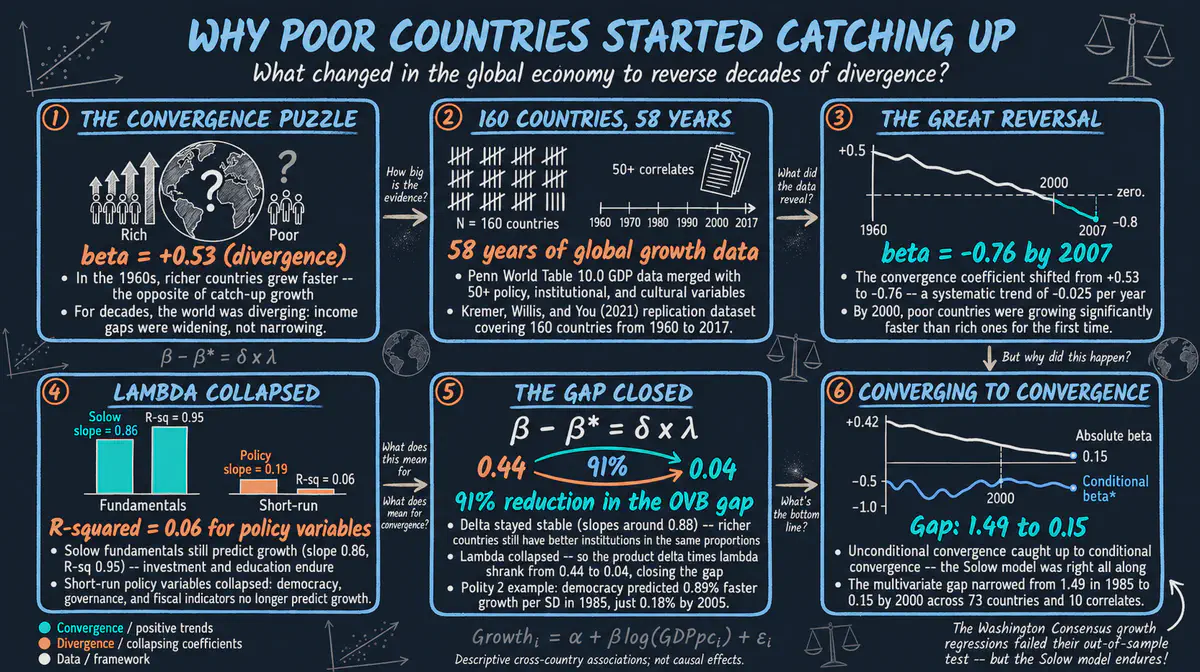
Reproduzca los hallazgos clave de Kremer, Willis y You (2021) para entender por qué surgió la convergencia incondicional desde el año 2000 y cómo la convergencia de los correlatos del crecimiento explica este cambio.
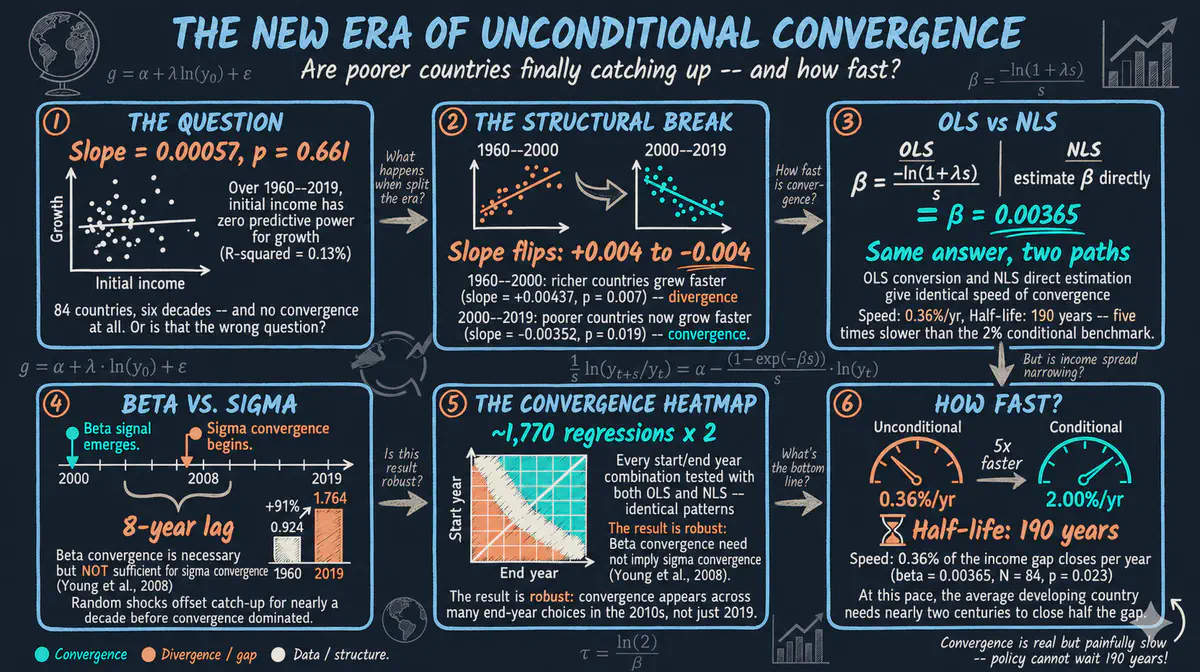
Compruebe si los países más pobres están alcanzando a los más ricos mediante el análisis de convergencia beta y sigma con datos de las Penn World Tables 10.0 en Stata.
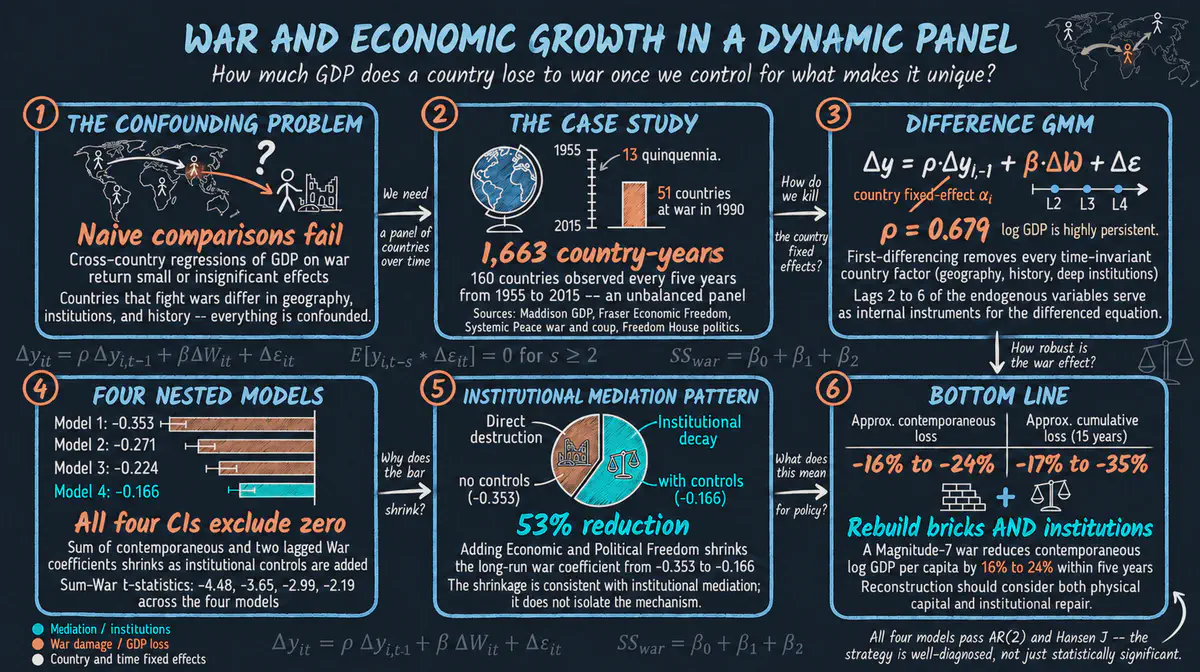
Estime el efecto dinámico de la guerra sobre el log del PIB per cápita dentro de cada país usando el GMM de Arellano-Bond en Stata, reproduciendo a Thies y Baum (2020) sobre un panel de 160 países entre 1955 y 2015.
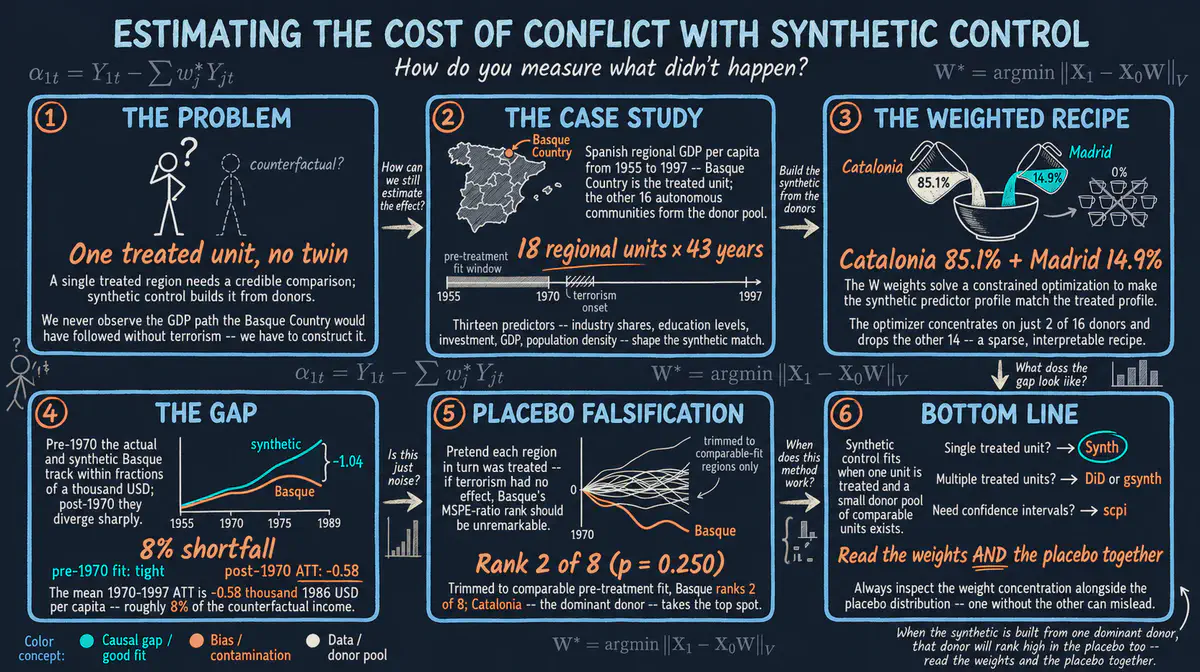
Un tutorial accesible para principiantes sobre el método de control sintético en R, utilizando el estudio de caso del País Vasco para estimar el costo económico del conflicto sobre el PIB per cápita regional desde 1970 hasta 1997.
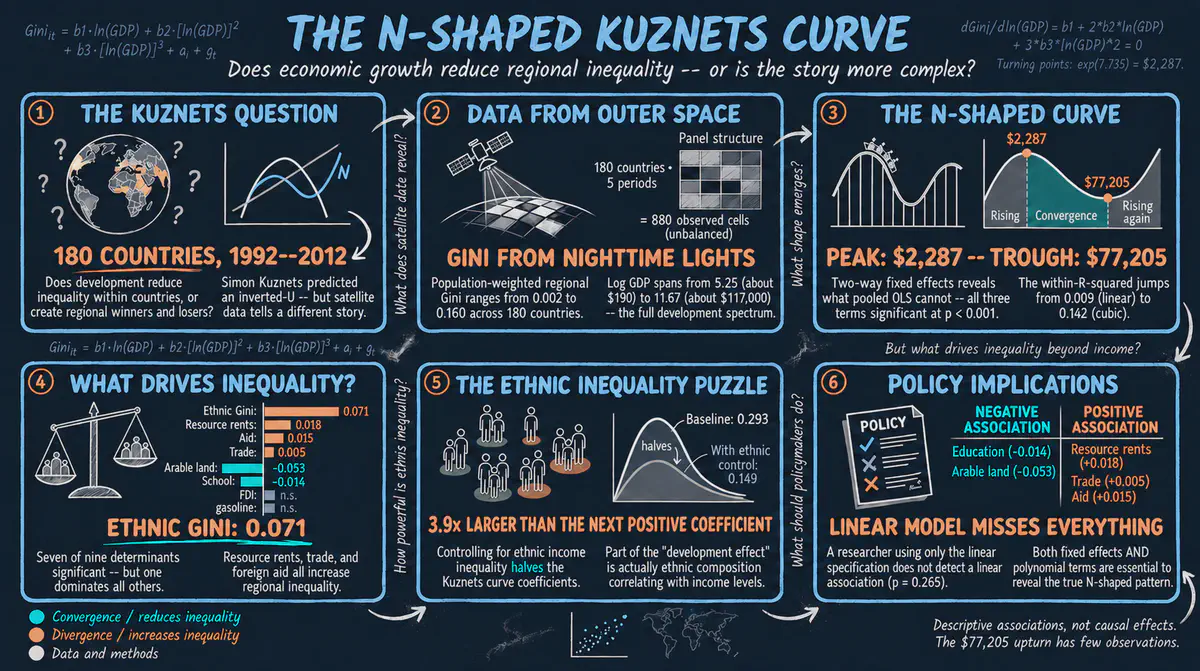
Replicación de la curva de Kuznets en forma de N con efectos fijos de datos de panel en Python usando PyFixest, desde el MCO agrupado hasta los efectos fijos bidireccionales, el análisis del punto de inflexión y los determinantes de la desigualdad regional en 180 países.
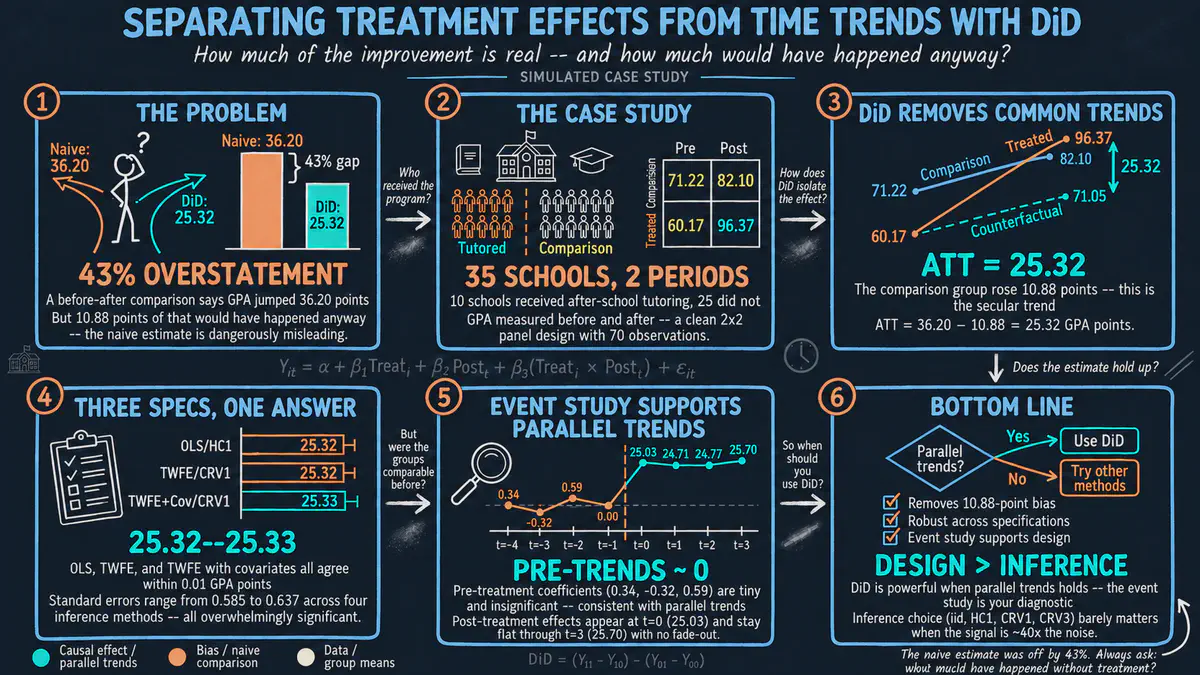
Aprenda Diferencias en Diferencias (DiD) en Python usando PyFixest y Great Tables. Cubre el diseño 2x2, la regresión TWFE, la comparación de inferencia, tablas con calidad de publicación, estudios de eventos y la prueba de tendencias paralelas basada en Corral y Yang (2024).
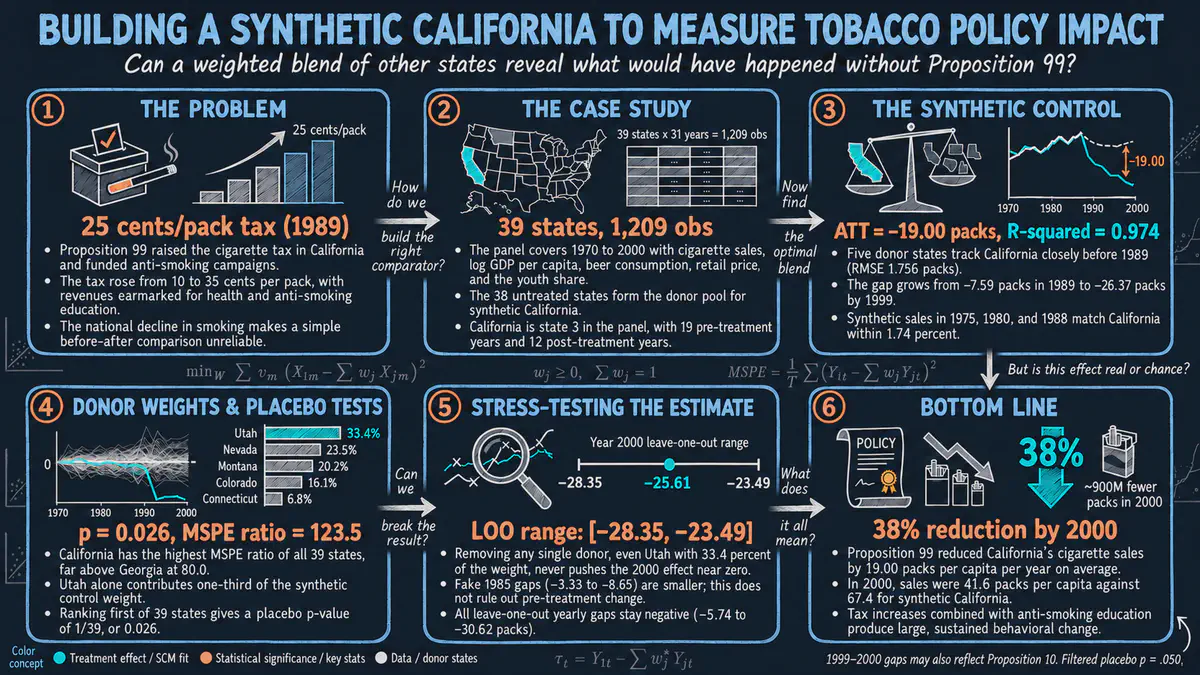
Estime el efecto causal del programa de control del tabaco de la Proposición 99 de California sobre las ventas de cigarrillos usando el método del control sintético en Stata, con pruebas de robustez de placebo en el espacio, placebo en el tiempo y de exclusión de una unidad a la vez.
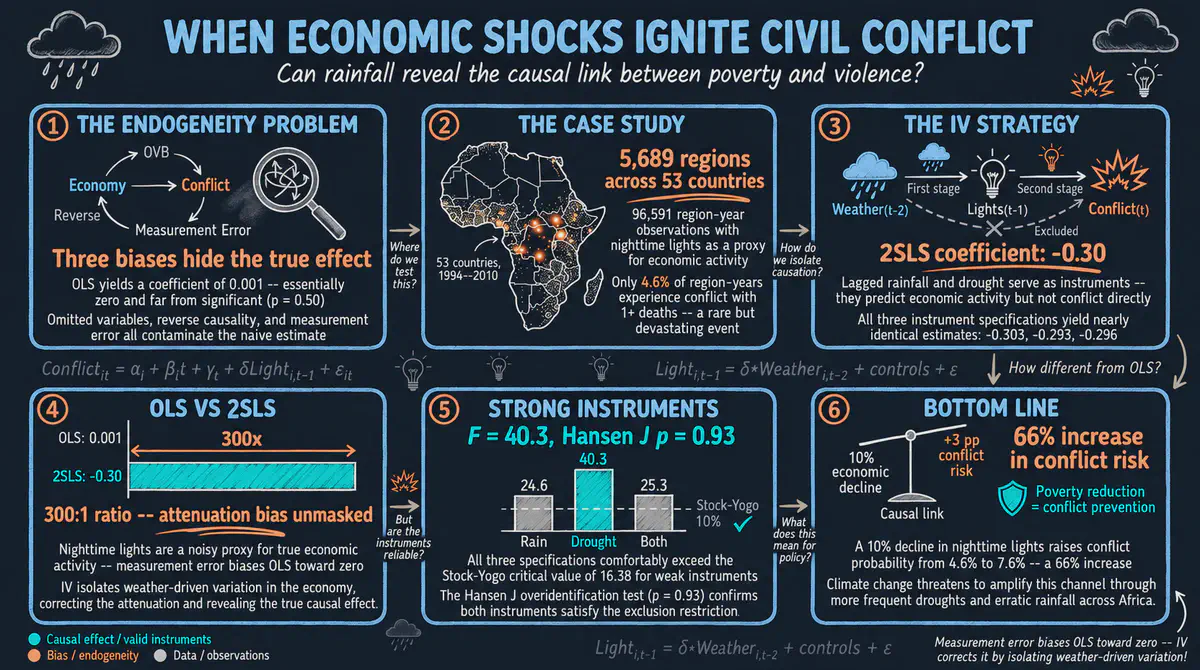
Replique a Hodler y Raschky (2014) para estimar el efecto causal de los choques económicos sobre el conflicto civil usando variables instrumentales por 2SLS con datos de panel de 5.689 regiones africanas.
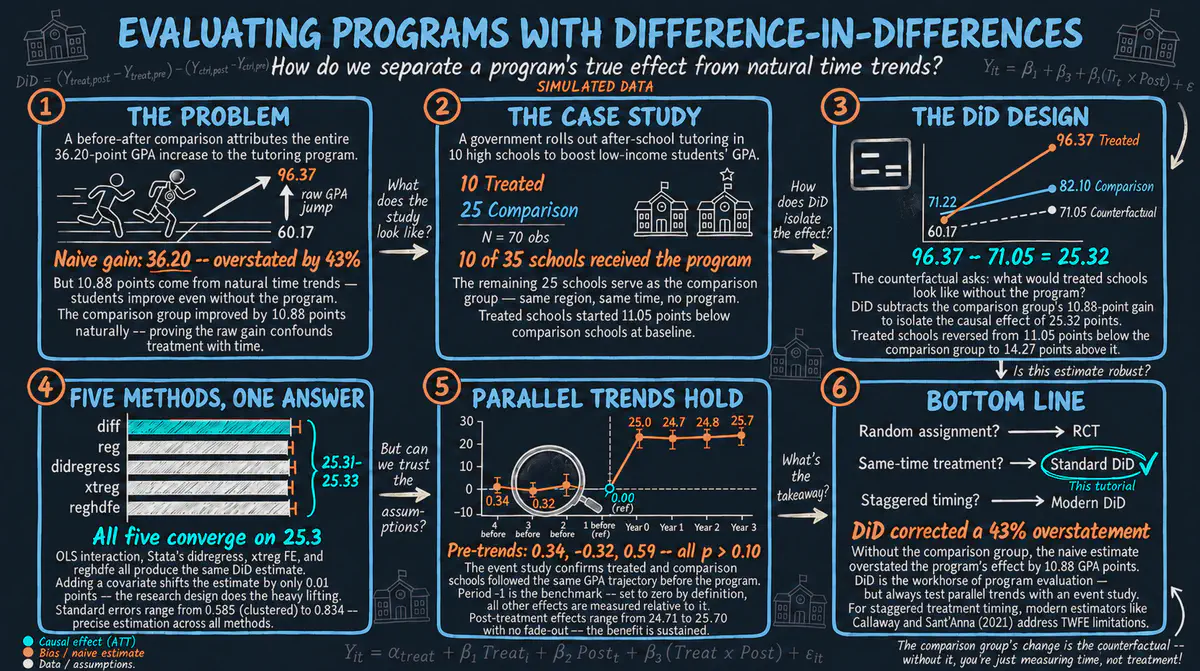
Aprenda las diferencias en diferencias (DiD) en Stata mediante un estudio de caso de un programa de tutorías extraescolares. Abarca el diseño 2x2, la regresión TWFE, los estudios de eventos y la prueba de tendencias paralelas, con base en Corral y Yang (2024).
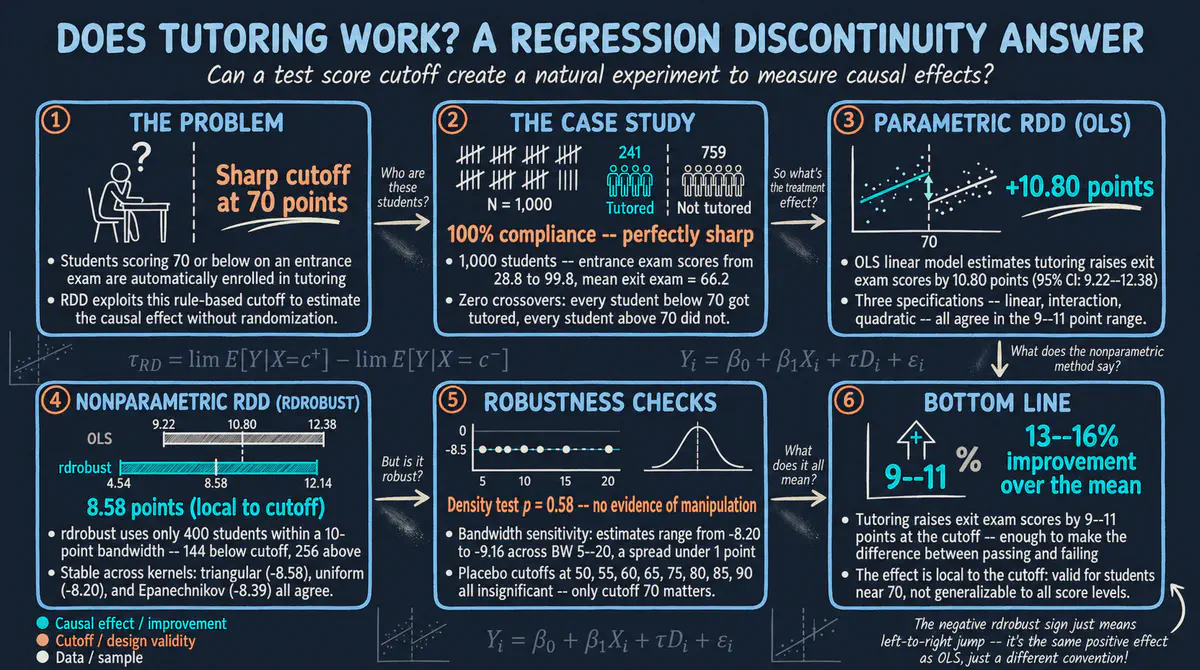
Evalúe el efecto causal de un programa de tutorías escolares sobre las calificaciones del examen de salida de los estudiantes usando un diseño de regresión discontinua nítido con estimación paramétrica por MCO y no paramétrica con rdrobust en Stata.
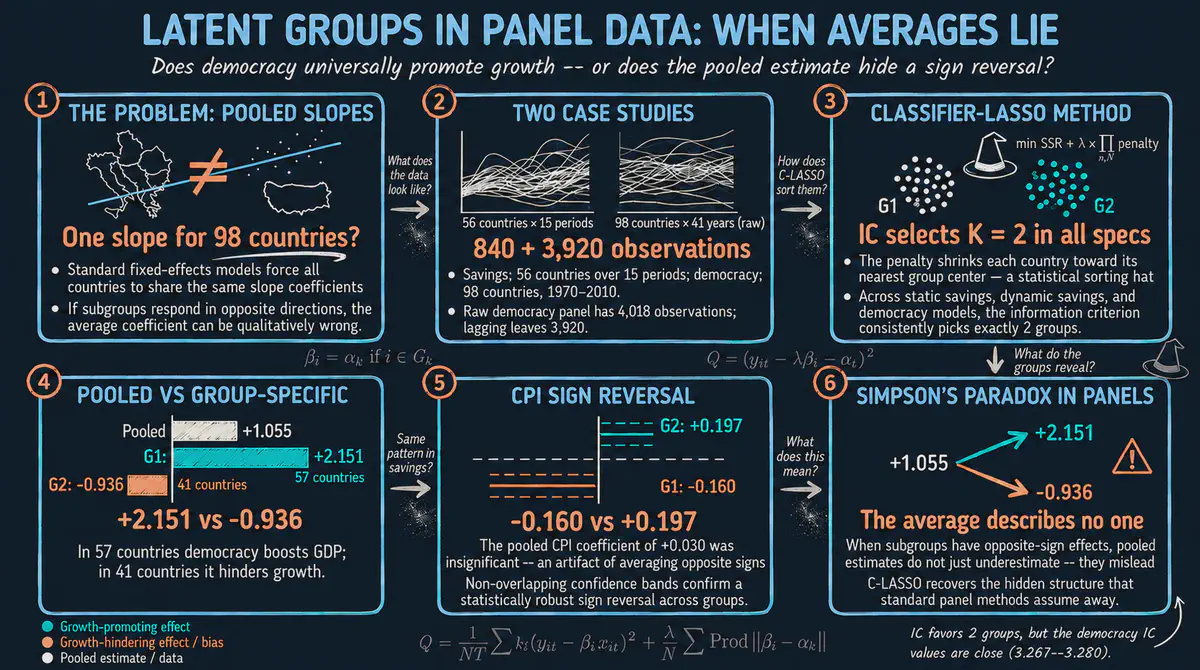
Identifique estructuras de grupos latentes en datos de panel usando el método Classifier-LASSO (Su, Shi, Phillips 2016), que revela cómo el efecto agrupado de la democracia sobre el crecimiento de +1,055 oculta un efecto de +2,151 en 57 países y un efecto de -0,936 en 41 países.
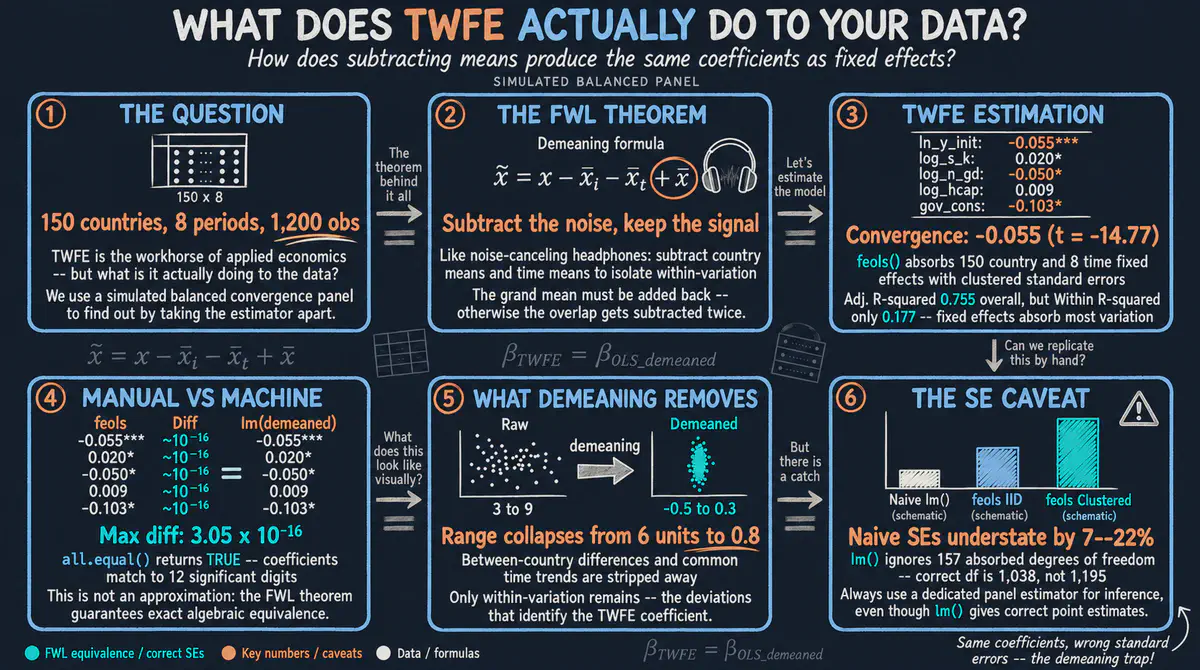
Centrado manual frente a efectos fijos de dos vías — mostrando que TWFE es simplemente MCO sobre datos centrados a través del teorema de Frisch-Waugh-Lovell, con una demostración práctica utilizando un panel de convergencia de Barro de 150 países.
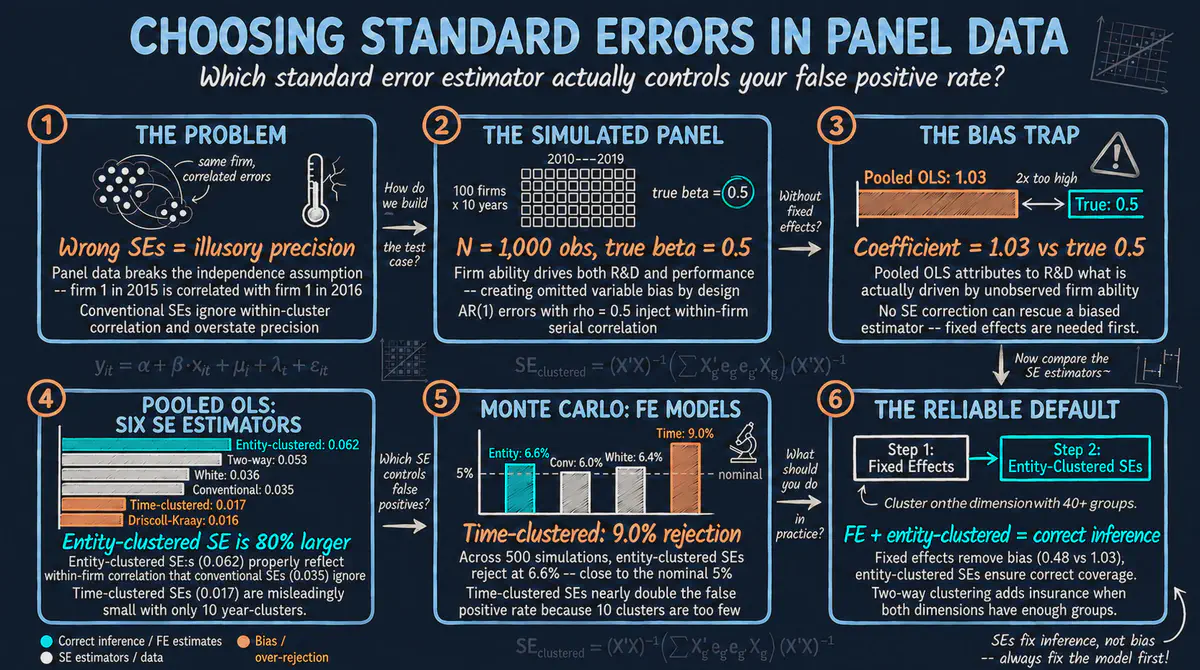
Comparación de estimadores de errores estándar en regresiones de datos de panel utilizando Python y linearmodels — desde los convencionales hasta los agrupados (clustered), Driscoll-Kraay y efectos fijos.
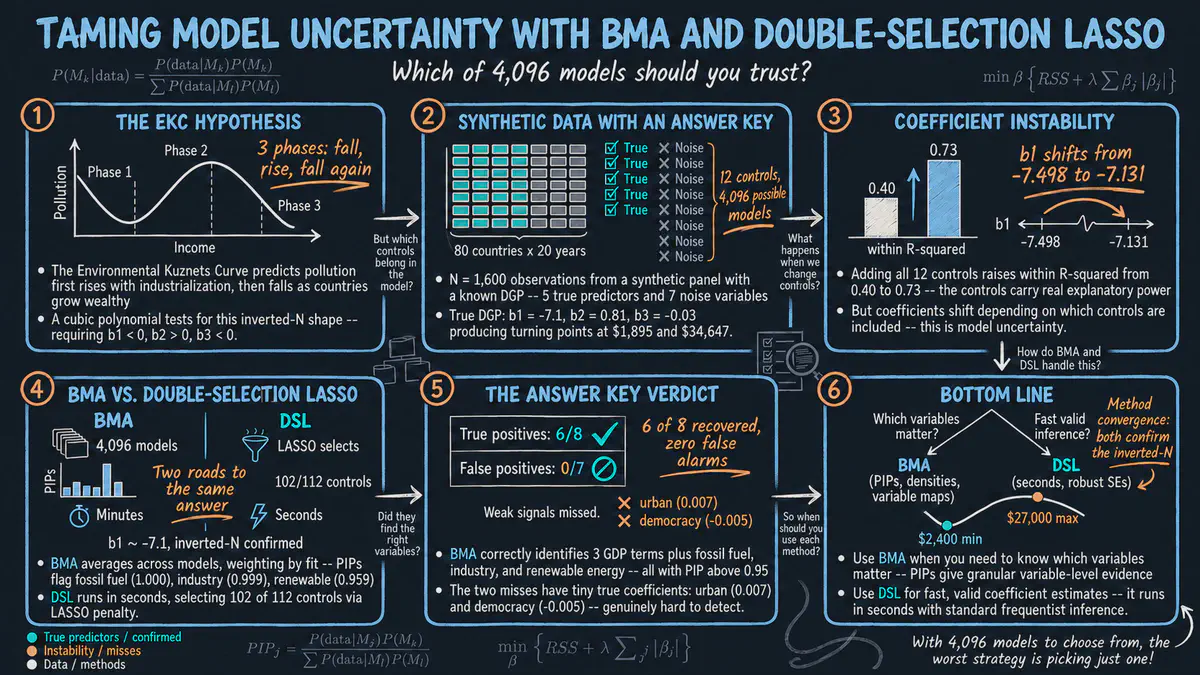
Bayesian Model Averaging (BMA) y LASSO de doble selección aplicados a la curva de Kuznets ambiental con datos de panel sintéticos cuya respuesta correcta es conocida, mostrando cómo ambos métodos recuperan los verdaderos predictores de las emisiones de CO2.
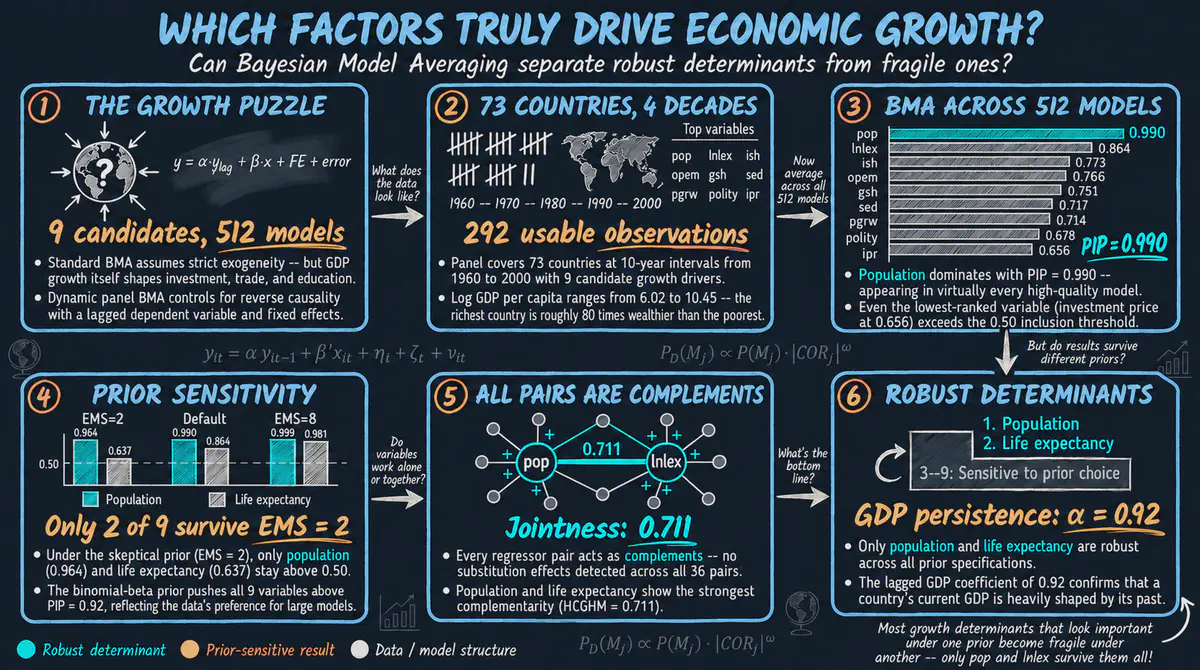
Promediado bayesiano de modelos (BMA) en paneles dinámicos con el paquete de R Bayesian Dynamic Systems Modeling (BDSM), aplicado a los determinantes del crecimiento económico entre países — abordando la causalidad inversa mediante variables dependientes rezagadas, efectos fijos y exogeneidad débil.
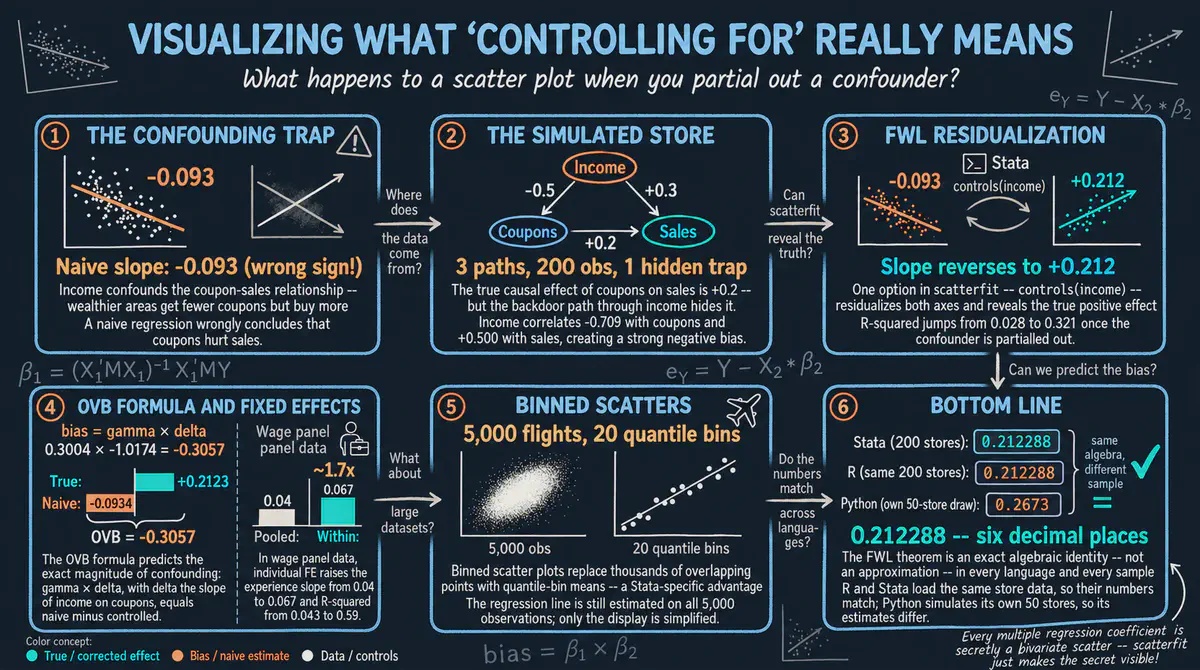
Una guía práctica del paquete scatterfit en Stata — desde la comprensión del teorema de Frisch-Waugh-Lovell mediante confusión simulada hasta la visualización de efectos fijos con datos de panel reales — que muestra cómo se ve “controlar por” en forma de diagrama de dispersión.
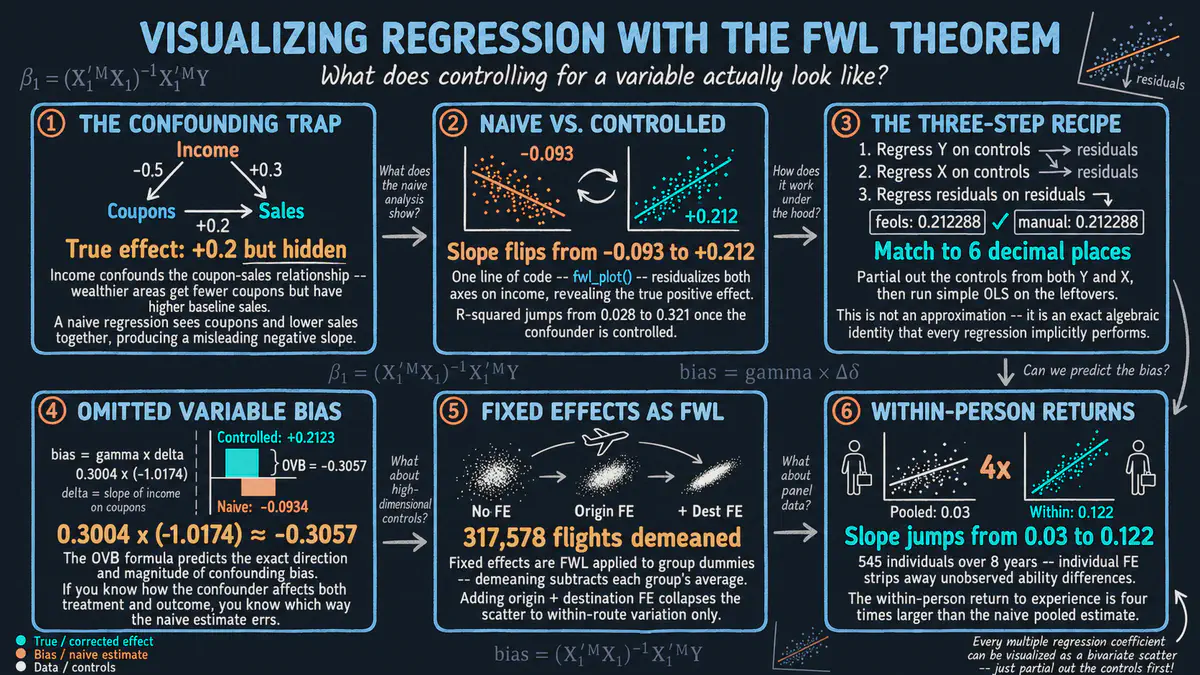
Una guía práctica sobre el paquete fwlplot en R — desde la comprensión del teorema de Frisch-Waugh-Lovell, pasando por la confusión simulada, hasta la visualización de efectos fijos en datos de panel reales — mostrando cómo se ve “controlar por” como un diagrama de dispersión.
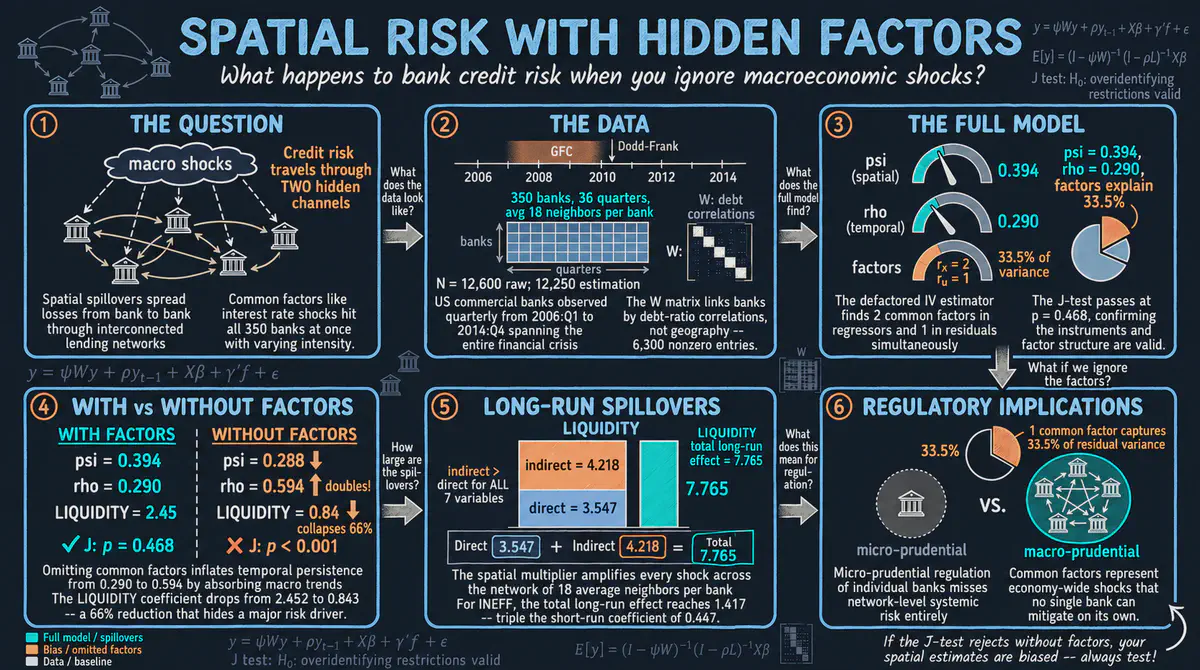
Estime modelos de panel dinámicos espaciales con factores comunes no observados usando el paquete spxtivdfreg en Stata — un enfoque IV que maneja rezagos espaciales, persistencia temporal, regresores endógenos y factores latentes de forma simultánea.
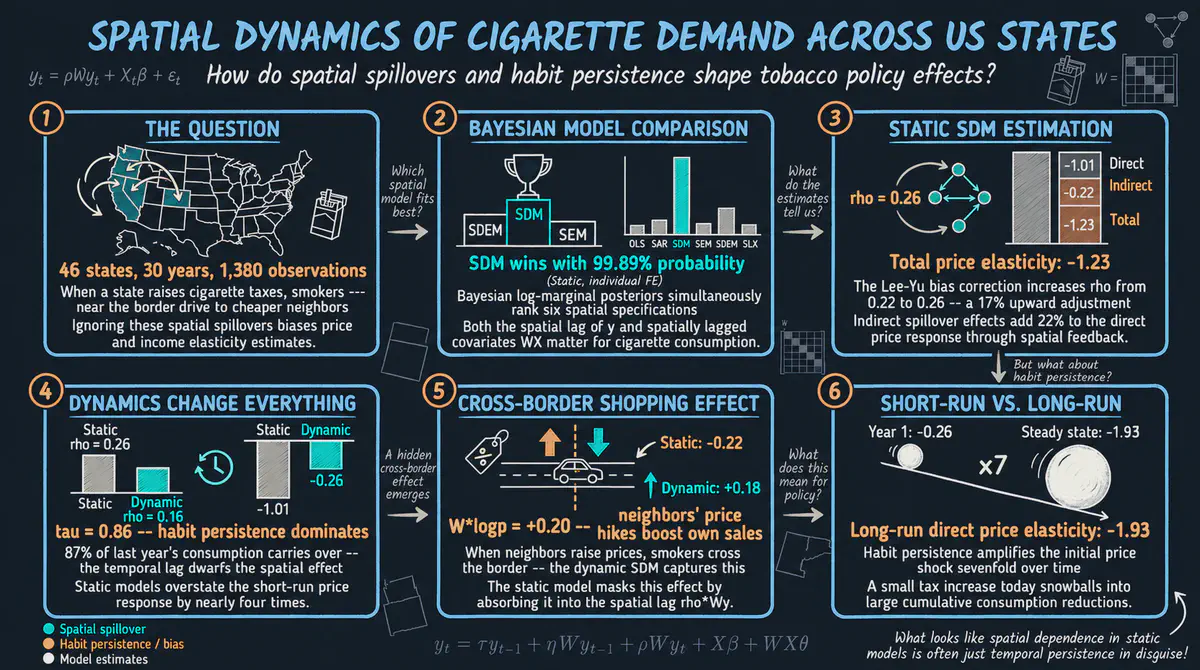
Una guía práctica para modelar datos de panel espaciales con el paquete SDPDmod en R — desde la comparación bayesiana de modelos hasta la estimación SAR/SDM estática y dinámica con corrección de sesgo de Lee-Yu, y la descomposición en efectos directos, indirectos y totales — aplicada a la demanda de cigarrillos en 46 estados de EE. UU. (1963–1992).
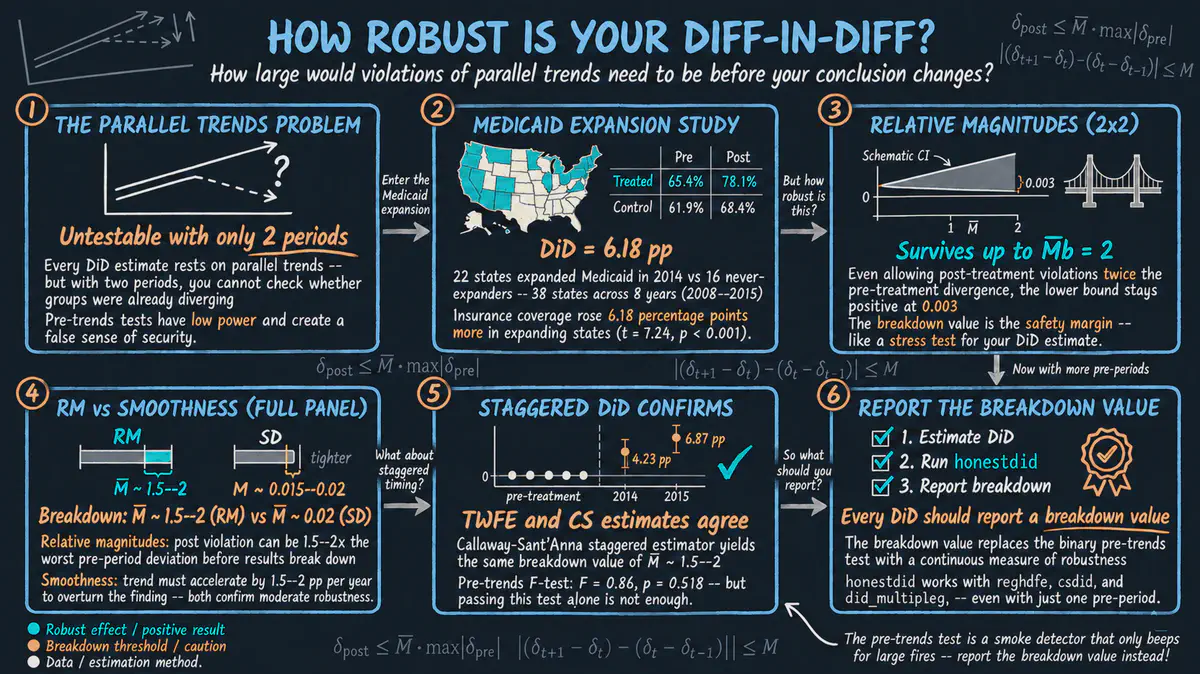
Evalúe qué tan robustos son los resultados de diferencias en diferencias ante violaciones de las tendencias paralelas usando el paquete honestdid en Stata, avanzando desde un DiD simple 2x2 hasta estudios de eventos multiperiodo con magnitudes relativas y restricciones de suavidad.
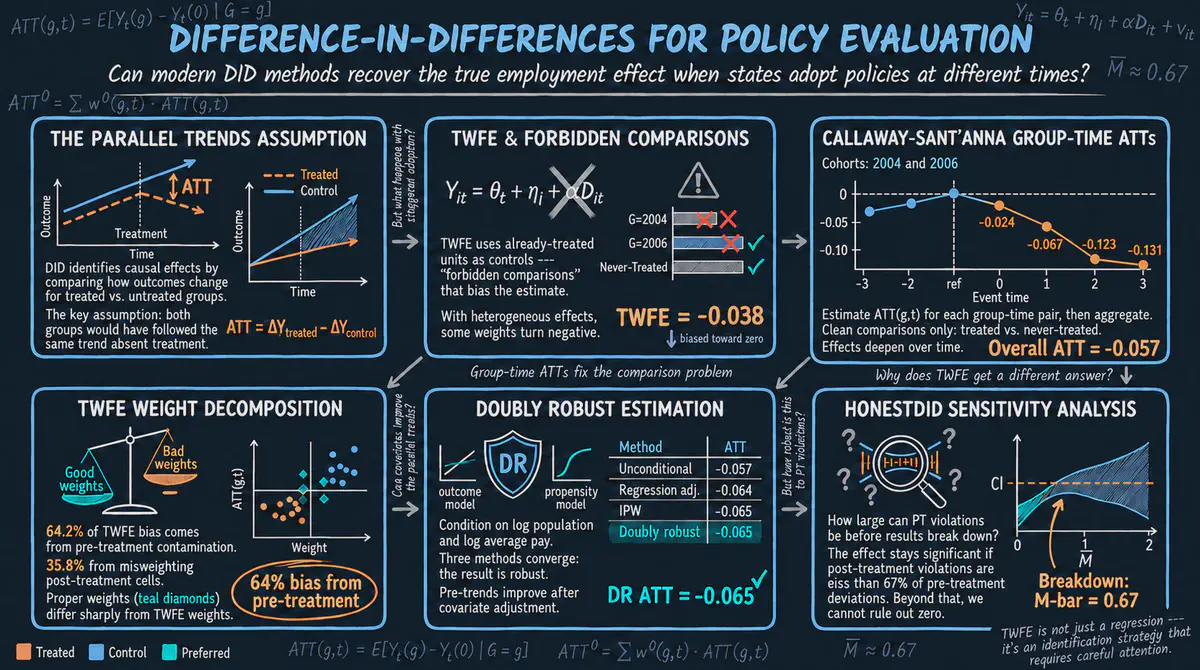
Una guía sobre Diferencias en Diferencias con tratamiento escalonado — desde las limitaciones de TWFE hasta los ATT por grupo-tiempo de Callaway-Sant’Anna, la estimación doblemente robusta y el análisis de sensibilidad HonestDiD — aplicada a los efectos del salario mínimo sobre el empleo juvenil.
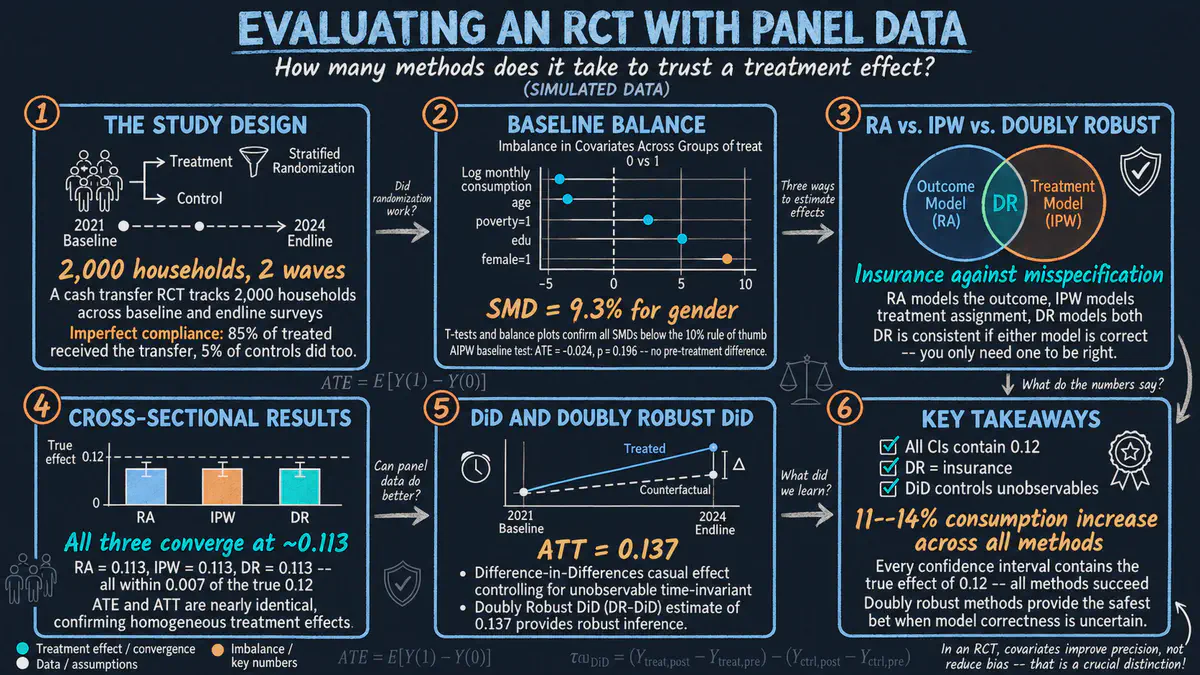
Evalúe el efecto causal de un programa de transferencias monetarias sobre el consumo de los hogares usando ajuste por regresión, ponderación por probabilidad inversa, métodos doblemente robustos y diferencias en diferencias en Stata.
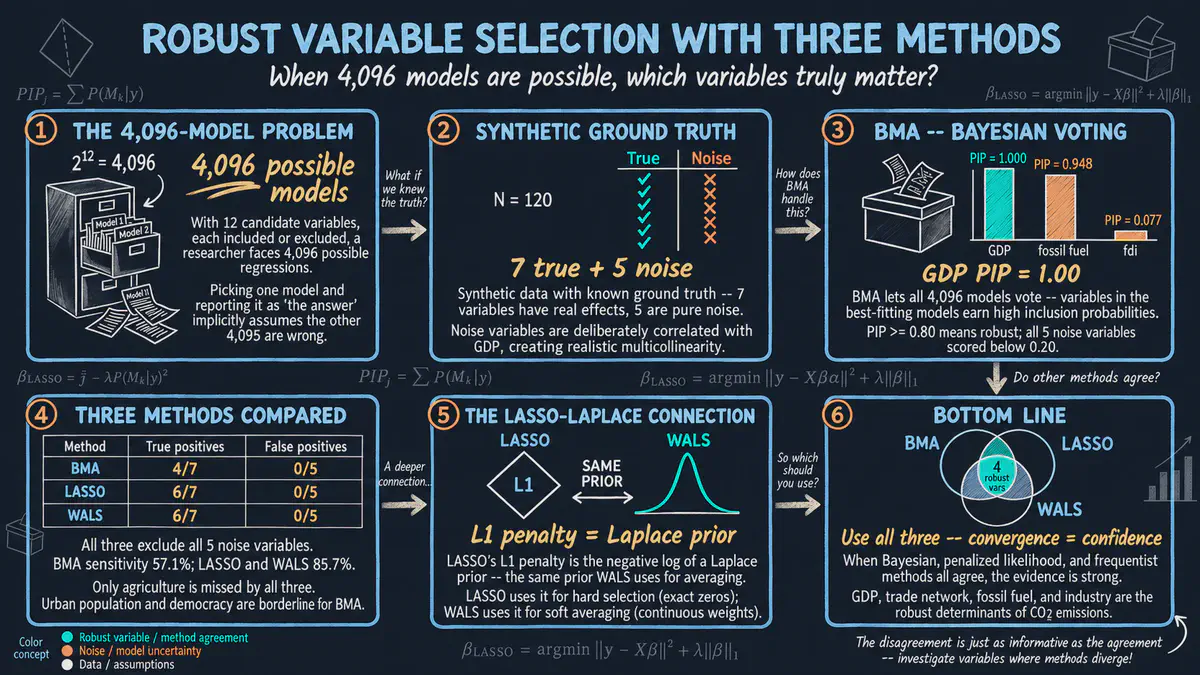
Tres enfoques fundamentados para la selección de variables—BMA, LASSO y WALS—aplicados a datos sintéticos de emisiones de CO2 entre países con verdad fundamental conocida, demostrando la triangulación metodológica para una inferencia robusta.
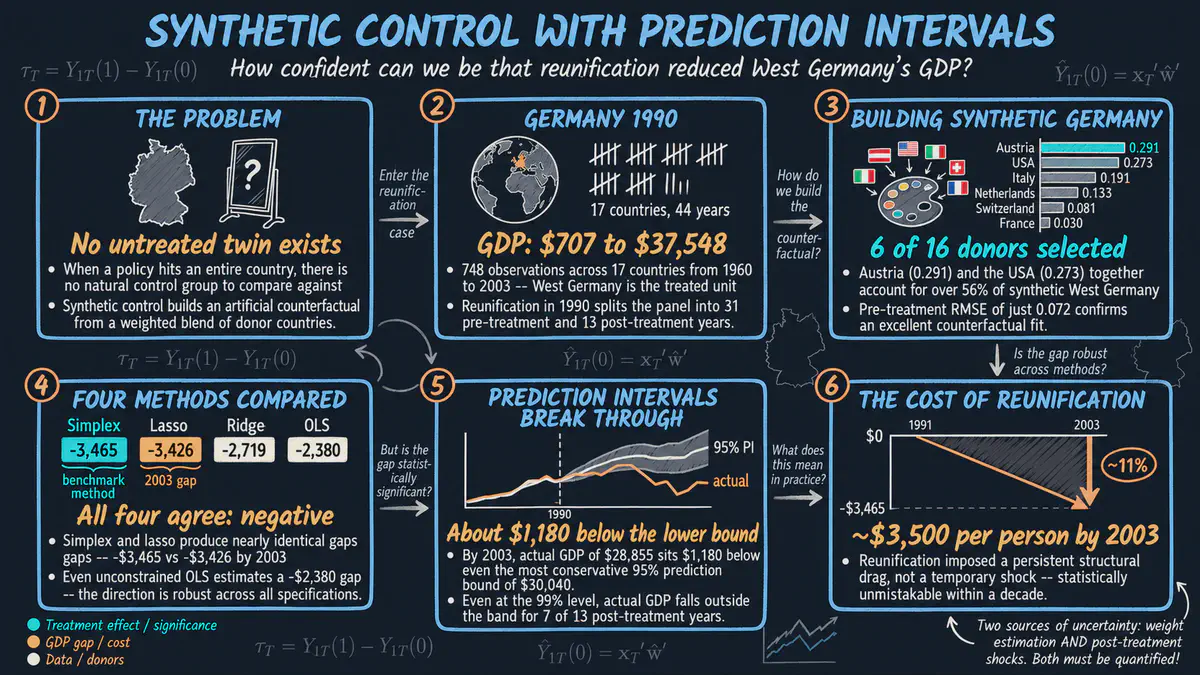
El control sintético con intervalos de predicción cuantifica la incertidumbre en el impacto de la reunificación alemana sobre el PIB utilizando el paquete scpi.
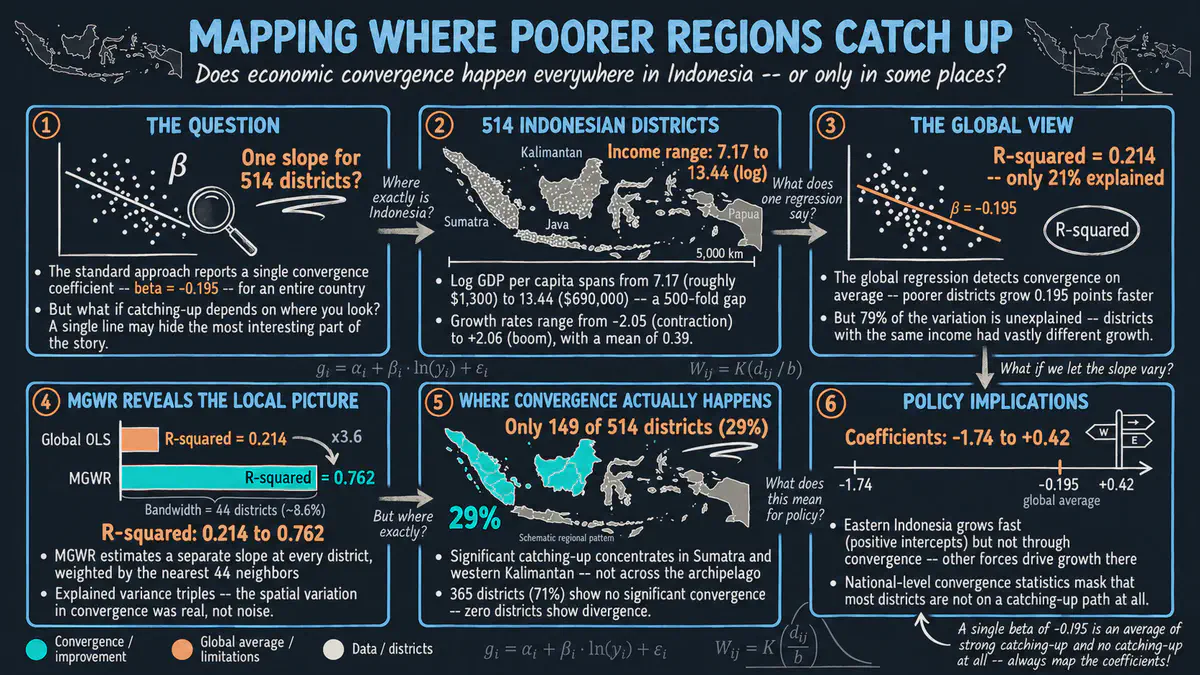
Aplicación de la regresión geográficamente ponderada multiescala (MGWR) para revelar cómo el alcance económico varía entre los 514 distritos de Indonesia, con cada variable operando en su propia escala espacial.
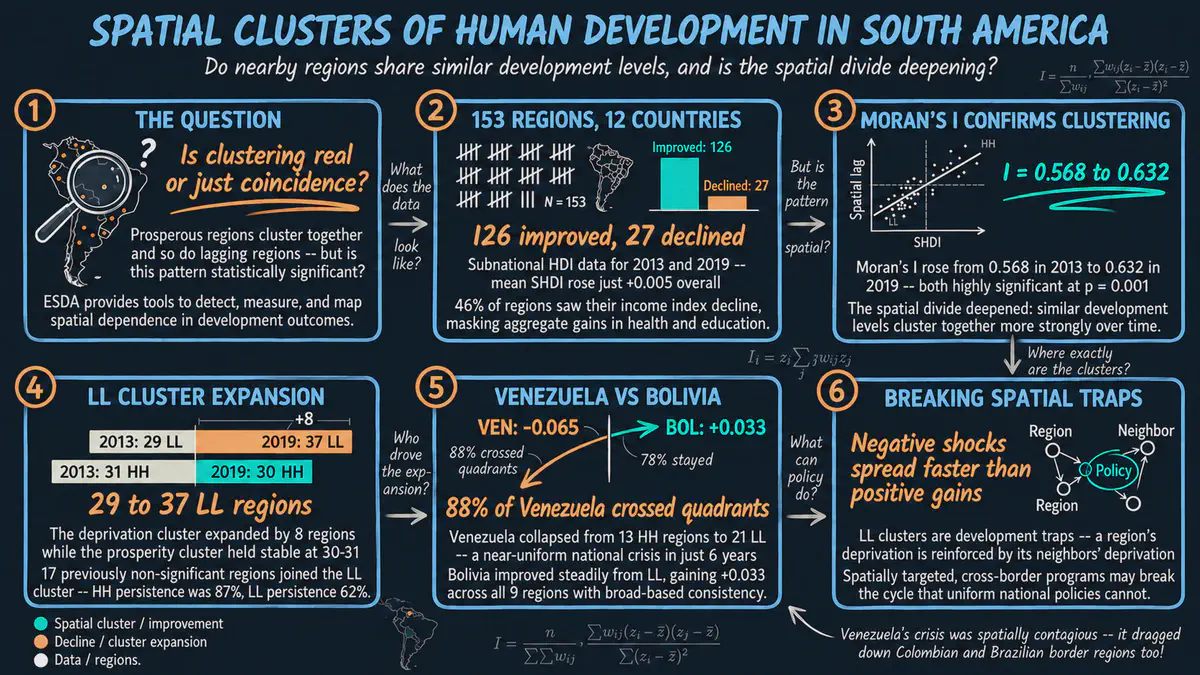
Una introducción al análisis exploratorio de datos espaciales usando PySAL, que abarca mapas coropléticos, pesos espaciales, la I de Moran, clústeres LISA, dinámica espacio-temporal y un análisis comparativo Venezuela-Bolivia para 153 regiones sudamericanas.
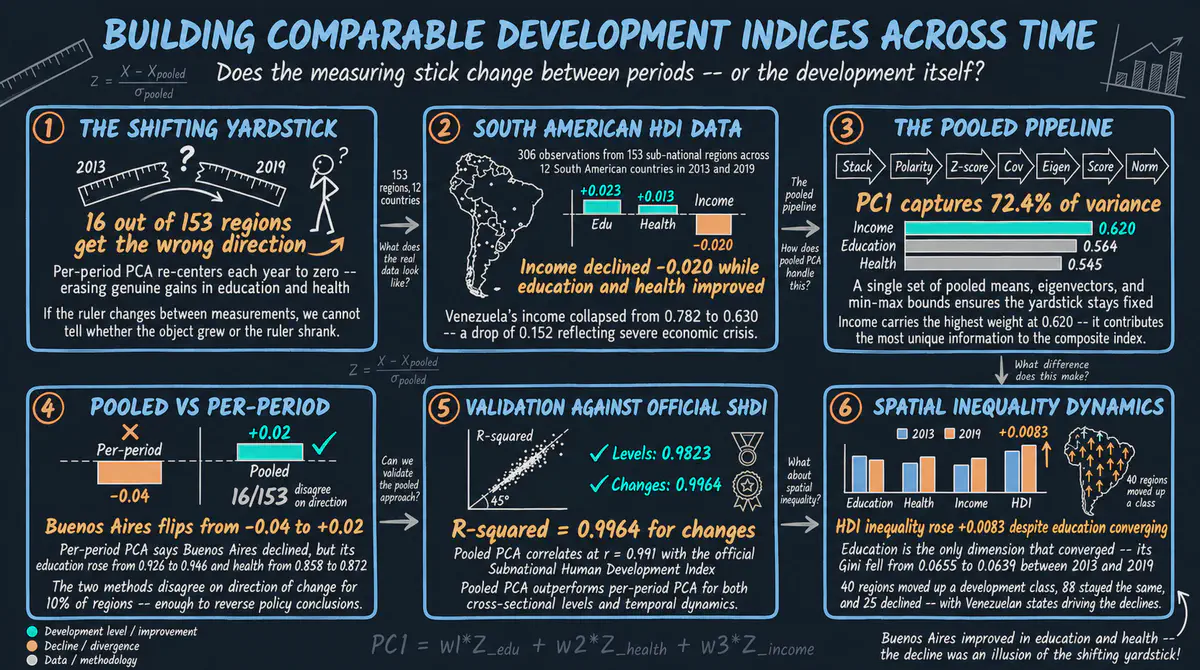
Construcción de un Índice de Desarrollo Humano comparable a lo largo de dos periodos utilizando PCA agrupado (pooled) con datos subnacionales reales para 153 regiones sudamericanas, contrastándolo con el PCA por periodo para mostrar por qué la estandarización agrupada es esencial para las comparaciones temporales.
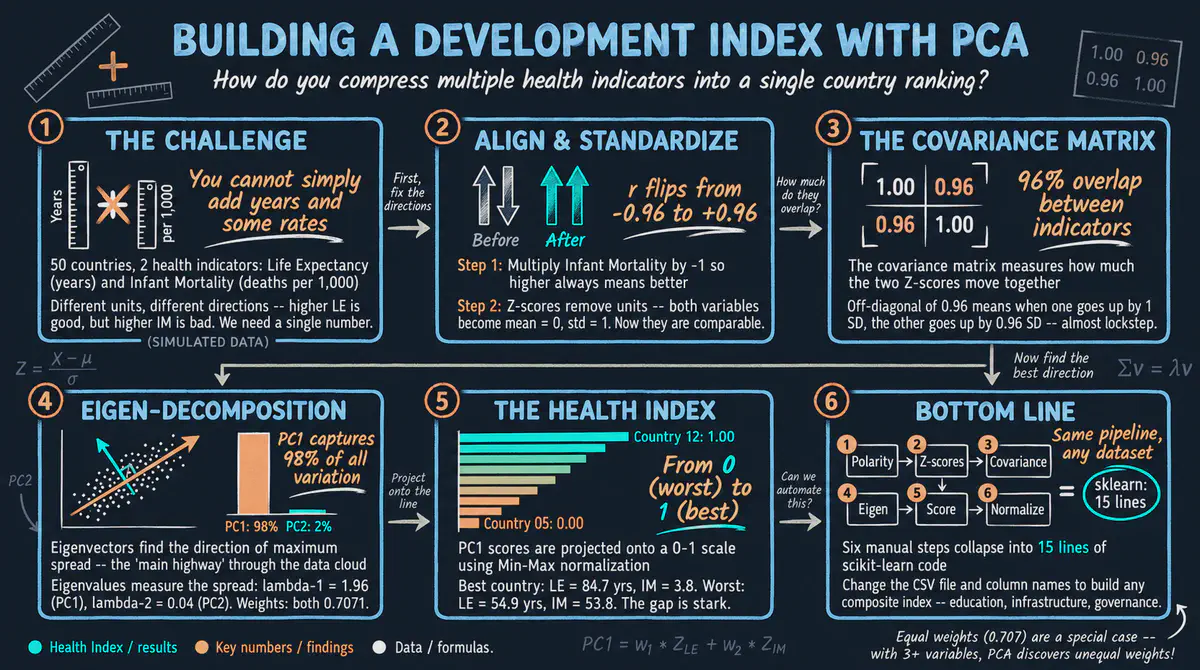
Construcción de un Índice de Salud compuesto a partir de la Esperanza de Vida y la Mortalidad Infantil utilizando PCA manual con datos simulados para 50 países, y posterior verificación con scikit-learn.
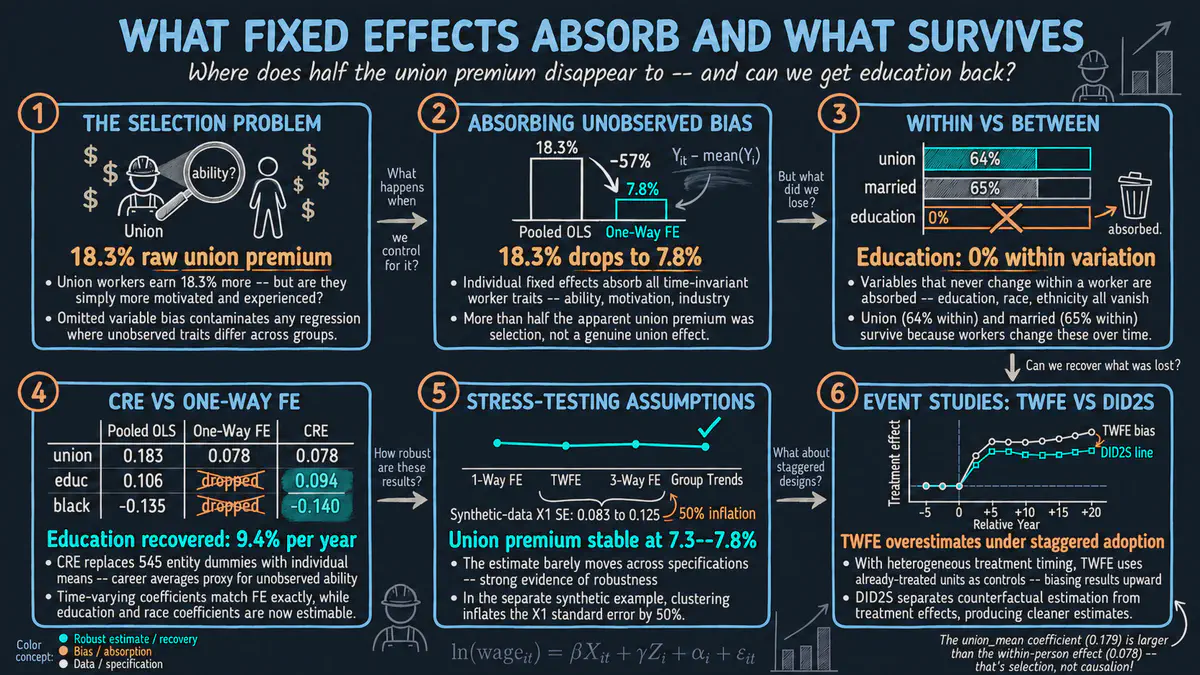
Estimación de modelos de regresión con efectos fijos de alta dimensión utilizando PyFixest, desde MCO simple hasta efectos fijos de dos vías, variables instrumentales, datos de panel y estudios de eventos.
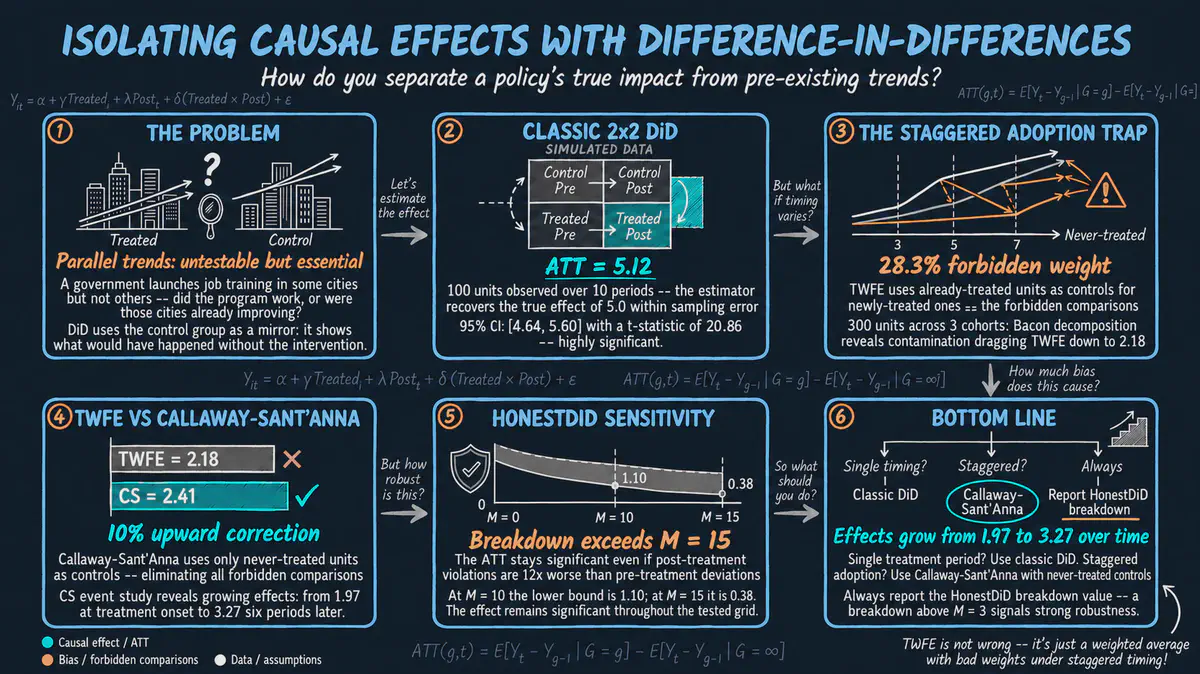
Estimación de efectos causales de tratamiento mediante Diferencias en Diferencias con el paquete diff-diff, desde el diseño clásico 2x2 hasta la adopción escalonada con Callaway-Sant’Anna y el análisis de sensibilidad HonestDiD.
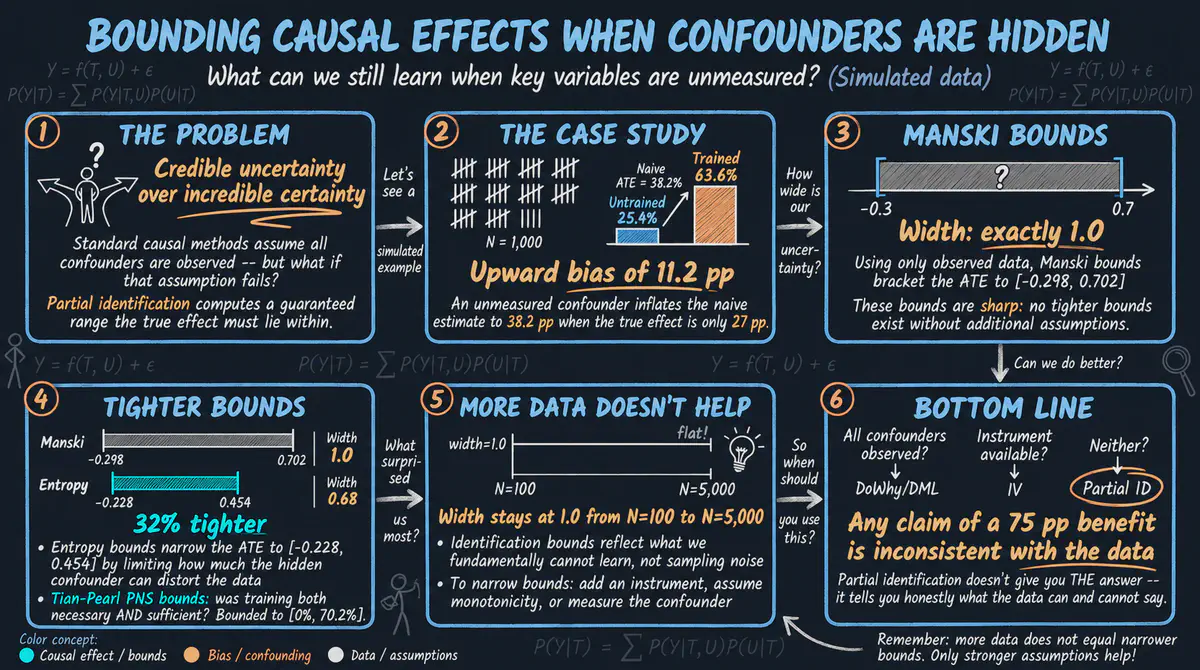
Cálculo de cotas causales bajo confusión no medida utilizando las cotas de Manski y de Tian-Pearl con el paquete CausalBoundingEngine en Python.
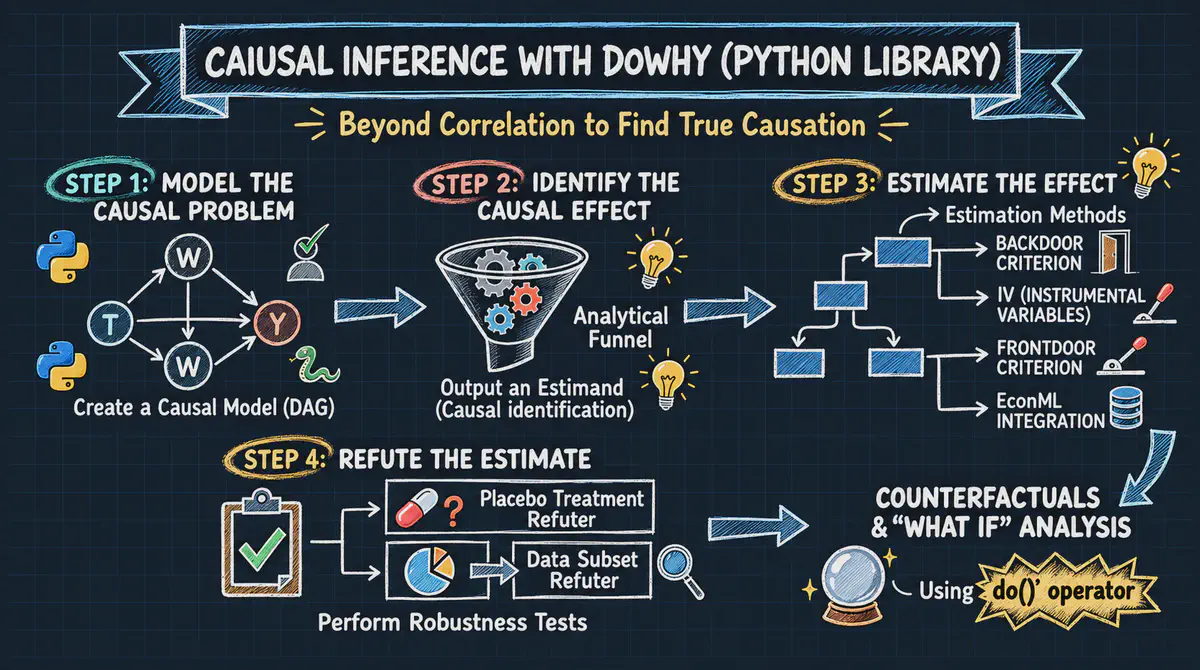
Estimación del efecto causal de un programa de capacitación laboral sobre los ingresos mediante el marco de inferencia causal de cuatro pasos de DoWhy con el conjunto de datos Lalonde.
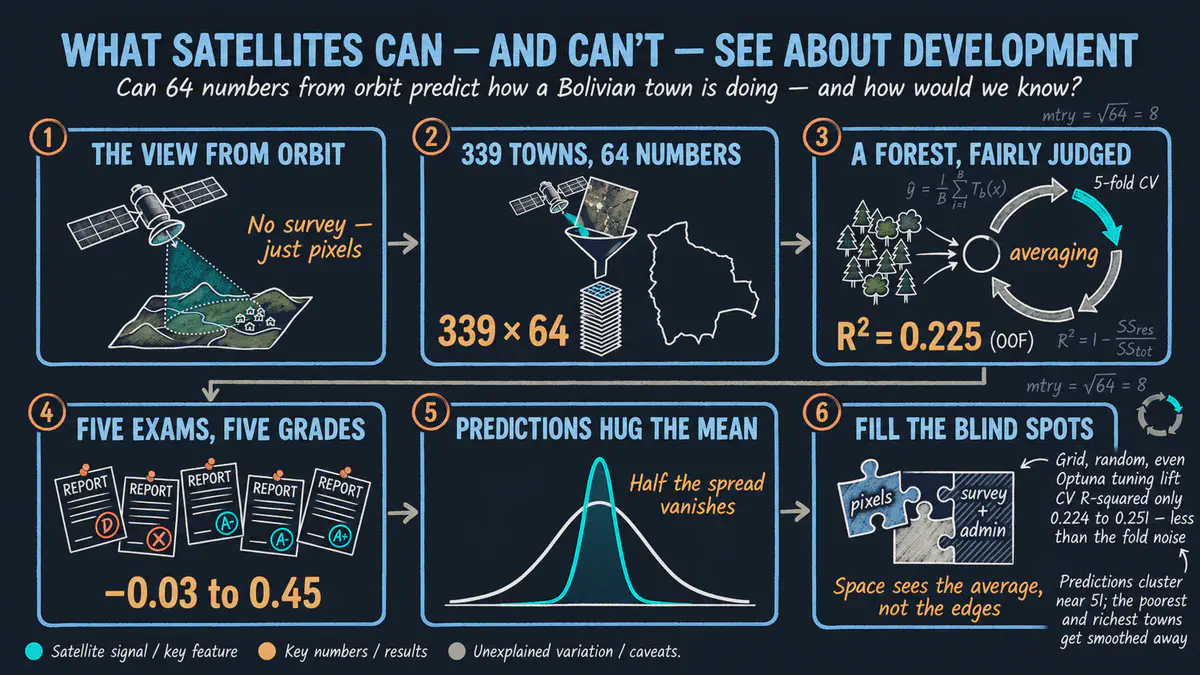
Introducción integral y apta para principiantes a la regresión con Random Forest para datos continuos, evaluada de principio a fin con validación cruzada de cinco particiones y predicciones fuera de pliegue (out-of-fold) sobre imágenes satelitales de Bolivia.
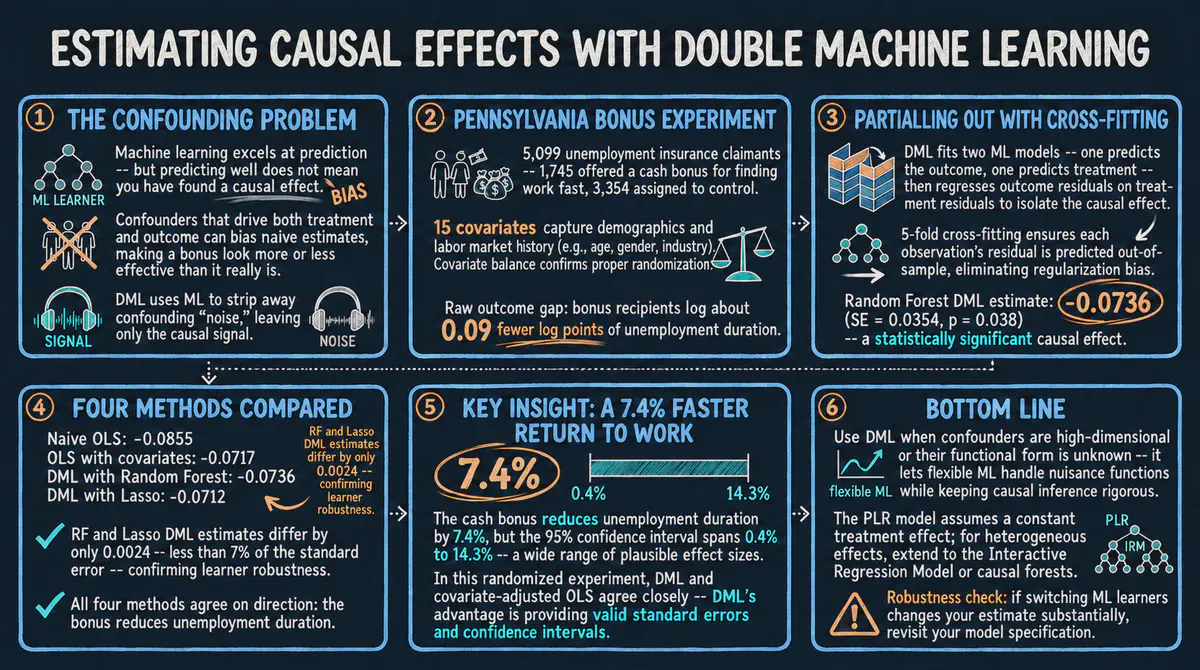
Estimación del efecto causal de una bonificación en efectivo sobre la duración del desempleo mediante Double Machine Learning con el Experimento de Bonificación de Pensilvania.
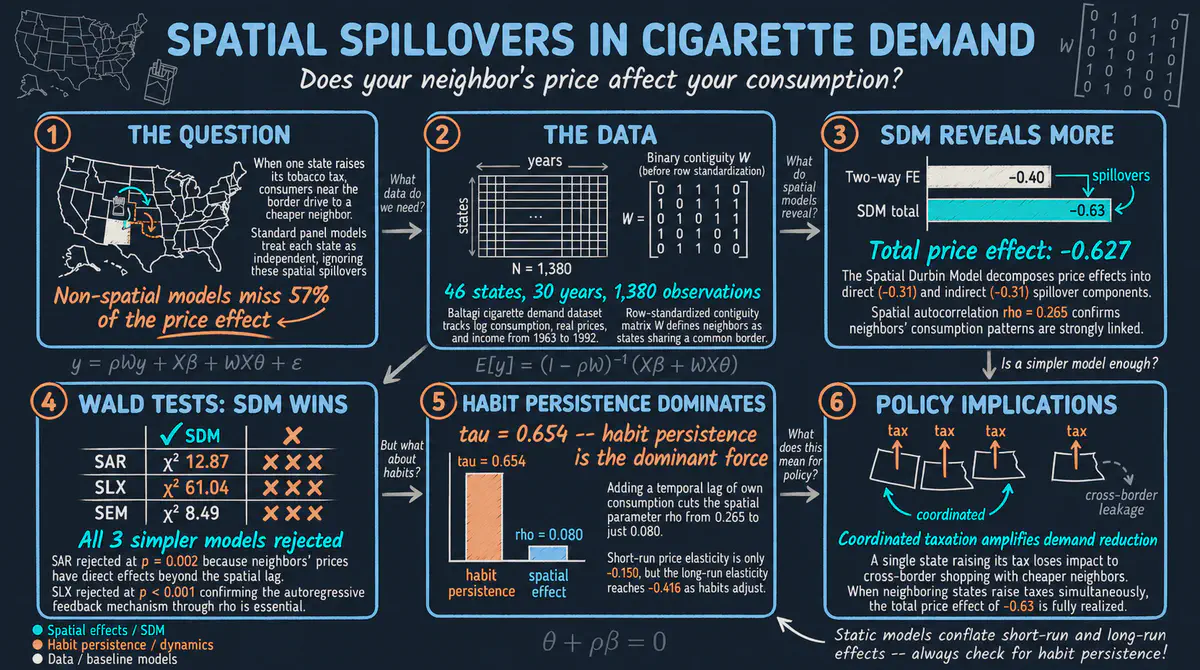
Modele los desbordamientos espaciales en datos de panel usando el modelo de Durbin espacial (SDM), pruebas de especificación de Wald y extensiones dinámicas con el paquete xsmle en Stata.
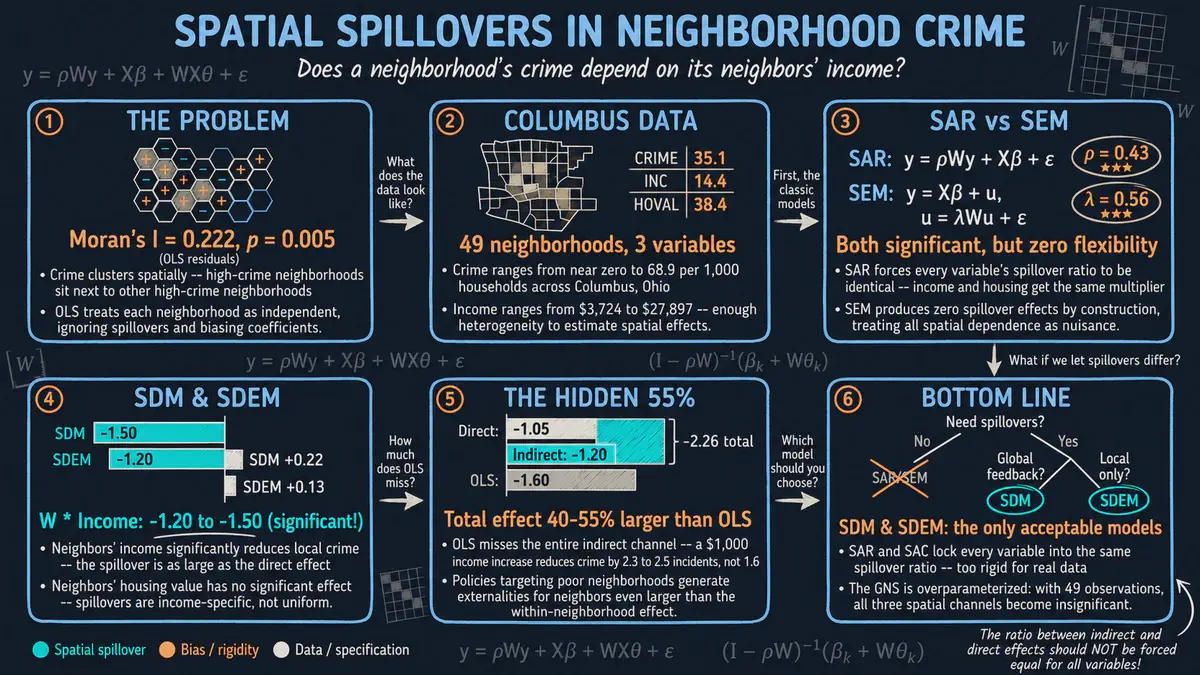
Explore la taxonomía completa de los modelos espaciales de corte transversal — MCO, SAR, SEM, SLX, SDM, SDEM, SAC y GNS — usando el conjunto de datos de delincuencia de Columbus en Stata, siguiendo a Elhorst (2014).